
📇 本类导航
本页自动汇总「SpringCloud学习」分类下的全部笔记(含子分类),随笔记增删实时更新。
1.初识Docker
1.1.什么是Docker
微服务虽然具备各种各样的优势,但服务的拆分通用给部署带来了很大的麻烦。
- 分布式系统中,依赖的组件非常多,不同组件之间部署时往往会产生一些冲突。
- 在数百上千台服务中重复部署,环境不一定一致,会遇到各种问题
1.1.1.应用部署的环境问题
大型项目组件较多,运行环境也较为复杂,部署时会碰到一些问题:
- 依赖关系复杂,容易出现兼容性问题
- 开发、测试、生产环境有差异
例如一个项目中,部署时需要依赖于node.js、Redis、RabbitMQ、MySQL等,这些服务部署时所需要的函数库、依赖项各不相同,甚至会有冲突。给部署带来了极大的困难。
1.1.2.Docker解决依赖兼容问题
而Docker确巧妙的解决了这些问题,Docker是如何实现的呢?
Docker为了解决依赖的兼容问题的,采用了两个手段:
将应用的Libs(函数库)、Deps(依赖)、配置与应用一起打包
将每个应用放到一个隔离容器去运行,避免互相干扰
这样打包好的应用包中,既包含应用本身,也保护应用所需要的Libs、Deps,无需再操作系统上安装这些,自然就不存在不同应用之间的兼容问题了。
虽然解决了不同应用的兼容问题,但是开发、测试等环境会存在差异,操作系统版本也会有差异,怎么解决这些问题呢?
1.1.3.Docker解决操作系统环境差异
要解决不同操作系统环境差异问题,必须先了解操作系统结构。以一个Ubuntu操作系统为例,结构如下:
结构包括:
- 计算机硬件:例如CPU、内存、磁盘等
- 系统内核:所有Linux发行版的内核都是Linux,例如CentOS、Ubuntu、Fedora等。内核可以与计算机硬件交互,对外提供内核指令,用于操作计算机硬件。
- 系统应用:操作系统本身提供的应用、函数库。这些函数库是对内核指令的封装,使用更加方便。
应用于计算机交互的流程如下:
1)应用调用操作系统应用(函数库),实现各种功能
2)系统函数库是对内核指令集的封装,会调用内核指令
3)内核指令操作计算机硬件
Ubuntu和CentOS都是基于Linux内核,无非是系统应用不同,提供的函数库有差异:
此时,如果将一个Ubuntu版本的MySQL应用安装到CentOS系统,MySQL在调用Ubuntu函数库时,会发现找不到或者不匹配,就会报错了:
Docker如何解决不同系统环境的问题?
- Docker将用户程序与所需要调用的系统(比如Ubuntu)函数库一起打包
- Docker运行到不同操作系统时,直接基于打包的函数库,借助于操作系统的Linux内核来运行
如图:
1.1.4.小结
Docker如何解决大型项目依赖关系复杂,不同组件依赖的兼容性问题?
- Docker允许开发中将应用、依赖、函数库、配置一起打包,形成可移植镜像
- Docker应用运行在容器中,使用沙箱机制,相互隔离
Docker如何解决开发、测试、生产环境有差异的问题?
- Docker镜像中包含完整运行环境,包括系统函数库,仅依赖系统的Linux内核,因此可以在任意Linux操作系统上运行
Docker是一个快速交付应用、运行应用的技术,具备下列优势:
- 可以将程序及其依赖、运行环境一起打包为一个镜像,可以迁移到任意Linux操作系统
- 运行时利用沙箱机制形成隔离容器,各个应用互不干扰
- 启动、移除都可以通过一行命令完成,方便快捷
1.2.Docker和虚拟机的区别
Docker可以让一个应用在任何操作系统中非常方便的运行。而以前我们接触的虚拟机,也能在一个操作系统中,运行另外一个操作系统,保护系统中的任何应用。
两者有什么差异呢?
虚拟机(virtual machine)是在操作系统中模拟硬件设备,然后运行另一个操作系统,比如在 Windows 系统里面运行 Ubuntu 系统,这样就可以运行任意的Ubuntu应用了。
Docker仅仅是封装函数库,并没有模拟完整的操作系统,如图:
对比来看:
小结:
Docker和虚拟机的差异:
- docker是一个系统进程;虚拟机是在操作系统中的操作系统
- docker体积小、启动速度快、性能好;虚拟机体积大、启动速度慢、性能一般
1.3.Docker架构
1.3.1.镜像和容器
Docker中有几个重要的概念:
镜像(Image) :Docker将应用程序及其所需的依赖、函数库、环境、配置等文件打包在一起,称为镜像。
容器(Container) :镜像中的应用程序运行后形成的进程就是容器,只是Docker会给容器进程做隔离,对外不可见。
一切应用最终都是代码组成,都是硬盘中的一个个的字节形成的文件。只有运行时,才会加载到内存,形成进程。
而镜像,就是把一个应用在硬盘上的文件、及其运行环境、部分系统函数库文件一起打包形成的文件包。这个文件包是只读的。
容器呢,就是将这些文件中编写的程序、函数加载到内存中允许,形成进程,只不过要隔离起来。因此一个镜像可以启动多次,形成多个容器进程。
例如你下载了一个QQ,如果我们将QQ在磁盘上的运行文件及其运行的操作系统依赖打包,形成QQ镜像。然后你可以启动多次,双开、甚至三开QQ,跟多个妹子聊天。
1.3.2.DockerHub
开源应用程序非常多,打包这些应用往往是重复的劳动。为了避免这些重复劳动,人们就会将自己打包的应用镜像,例如Redis、MySQL镜像放到网络上,共享使用,就像GitHub的代码共享一样。
- DockerHub:DockerHub是一个官方的Docker镜像的托管平台。这样的平台称为Docker Registry。
- 国内也有类似于DockerHub 的公开服务,比如 网易云镜像服务、阿里云镜像库等。
我们一方面可以将自己的镜像共享到DockerHub,另一方面也可以从DockerHub拉取镜像:
1.3.3.Docker架构
我们要使用Docker来操作镜像、容器,就必须要安装Docker。
Docker是一个CS架构的程序,由两部分组成:
- 服务端(server):Docker守护进程,负责处理Docker指令,管理镜像、容器等
- 客户端(client):通过命令或RestAPI向Docker服务端发送指令。可以在本地或远程向服务端发送指令。
如图:
1.3.4.小结
镜像:
- 将应用程序及其依赖、环境、配置打包在一起
容器:
- 镜像运行起来就是容器,一个镜像可以运行多个容器
Docker结构:
- 服务端:接收命令或远程请求,操作镜像或容器
- 客户端:发送命令或者请求到Docker服务端
DockerHub:
- 一个镜像托管的服务器,类似的还有阿里云镜像服务,统称为DockerRegistry
1.4.安装Docker
企业部署一般都是采用Linux操作系统,而其中又数CentOS发行版占比最多,因此我们在CentOS下安装Docker。参考课前资料中的文档:
2.Docker的基本操作
2.1.镜像操作
2.1.1.镜像名称
首先来看下镜像的名称组成:
- 镜名称一般分两部分组成:[repository]:[tag]。
- 在没有指定tag时,默认是latest,代表最新版本的镜像
如图:
这里的mysql就是repository,5.7就是tag,合一起就是镜像名称,代表5.7版本的MySQL镜像。
2.1.2.镜像命令
常见的镜像操作命令如图:
2.1.3.案例1-拉取、查看镜像
需求:从DockerHub中拉取一个nginx镜像并查看
1)首先去镜像仓库搜索nginx镜像,比如DockerHub:
2)根据查看到的镜像名称,拉取自己需要的镜像,通过命令:docker pull nginx
3)通过命令:docker images 查看拉取到的镜像
2.1.4.案例2-保存、导入镜像
需求:利用docker save将nginx镜像导出磁盘,然后再通过load加载回来
1)利用docker xx --help命令查看docker save和docker load的语法
例如,查看save命令用法,可以输入命令:
docker save --help结果:
命令格式:
docker save -o [保存的目标文件名称] [镜像名称]2)使用docker save导出镜像到磁盘
运行命令:
docker save -o nginx.tar nginx:latest结果如图:
3)使用docker load加载镜像
先删除本地的nginx镜像:
docker rmi nginx:latest然后运行命令,加载本地文件:
docker load -i nginx.tar结果:
2.1.5.练习
需求:去DockerHub搜索并拉取一个Redis镜像
目标:
1)去DockerHub搜索Redis镜像
2)查看Redis镜像的名称和版本
3)利用docker pull命令拉取镜像
4)利用docker save命令将 redis:latest打包为一个redis.tar包
5)利用docker rmi 删除本地的redis:latest
6)利用docker load 重新加载 redis.tar文件
2.2.容器操作
2.2.1.容器相关命令
容器操作的命令如图:
容器保护三个状态:
- 运行:进程正常运行
- 暂停:进程暂停,CPU不再运行,并不释放内存
- 停止:进程终止,回收进程占用的内存、CPU等资源
其中:
- docker run:创建并运行一个容器,处于运行状态
- docker pause:让一个运行的容器暂停
- docker unpause:让一个容器从暂停状态恢复运行
- docker stop:停止一个运行的容器
- docker start:让一个停止的容器再次运行
- docker rm:删除一个容器
2.2.2.案例-创建并运行一个容器
创建并运行nginx容器的命令:
docker run --name containerName -p 80:80 -d nginx命令解读:
- docker run :创建并运行一个容器
- --name : 给容器起一个名字,比如叫做mn
- -p :将宿主机端口与容器端口映射,==冒号左侧是宿主机端口,右侧是容器端口==
- -d:后台运行容器
- nginx:镜像名称,例如nginx
这里的
-p参数,是将容器端口映射到宿主机端口。默认情况下,容器是隔离环境,我们直接访问宿主机的80端口,肯定访问不到容器中的nginx。
现在,将容器的80与宿主机的80关联起来,当我们访问宿主机的80端口时,就会被映射到容器的80,这样就能访问到nginx了:
2.2.3.案例-进入容器,修改文件
需求:进入Nginx容器,修改HTML文件内容,添加“传智教育欢迎您”
提示:进入容器要用到docker exec命令。
步骤:
1)进入容器。进入我们刚刚创建的nginx容器的命令为:
docker exec -it mn bash命令解读:
- docker exec :进入容器内部,执行一个命令
- -it : 给当前进入的容器创建一个标准输入、输出终端,允许我们与容器交互
- mn :要进入的容器的名称
- bash:进入容器后执行的命令,bash是一个linux终端交互命令
2)进入nginx的HTML所在目录 /usr/share/nginx/html
容器内部会模拟一个独立的Linux文件系统,看起来如同一个linux服务器一样:
nginx的环境、配置、运行文件全部都在这个文件系统中,包括我们要修改的html文件。
查看DockerHub网站中的nginx页面,可以知道nginx的html目录位置在
/usr/share/nginx/html我们执行命令,进入该目录:
cd /usr/share/nginx/html查看目录下文件:
3)修改index.html的内容
容器内没有vi命令,无法直接修改,我们用下面的命令来修改:
sed -i -e 's#Welcome to nginx#传智教育欢迎您#g' -e 's#<head>#<head><meta charset="utf-8">#g' index.html在浏览器访问自己的虚拟机地址,例如我的是:http://192.168.150.101,即可看到结果:
2.2.4.小结
docker run命令的常见参数有哪些?
- --name:指定容器名称
- -p:指定端口映射
- -d:让容器后台运行
查看容器日志的命令:
- docker logs
- 添加 -f 参数可以持续查看日志
查看容器状态:
- docker ps
- docker ps -a 查看所有容器,包括已经停止的
2.3.数据卷(容器数据管理)
在之前的nginx案例中,修改nginx的html页面时,需要进入nginx内部。并且因为没有编辑器,修改文件也很麻烦。
这就是因为容器与数据(容器内文件)耦合带来的后果。
要解决这个问题,必须将数据与容器解耦,这就要用到数据卷了。
2.3.1.什么是数据卷
**数据卷(volume)**是一个虚拟目录,指向宿主机文件系统中的某个目录。
一旦完成数据卷挂载,对容器的一切操作都会作用在数据卷对应的宿主机目录了。
这样,我们操作宿主机的/var/lib/docker/volumes/html目录,就等于操作容器内的/usr/share/nginx/html目录了
2.3.2.数据集操作命令
数据卷操作的基本语法如下:
docker volume [COMMAND]docker volume命令是数据卷操作,根据命令后跟随的command来确定下一步的操作:
- create 创建一个volume
- inspect 显示一个或多个volume的信息
- ls 列出所有的volume
- prune 删除未使用的volume
- rm 删除一个或多个指定的volume
2.3.3.创建和查看数据卷
需求:创建一个数据卷,并查看数据卷在宿主机的目录位置
① 创建数据卷
docker volume create html② 查看所有数据
docker volume ls结果:
③ 查看数据卷详细信息卷
docker volume inspect html结果:
可以看到,我们创建的html这个数据卷关联的宿主机目录为
/var/lib/docker/volumes/html/_data目录。小结:
数据卷的作用:
- 将容器与数据分离,解耦合,方便操作容器内数据,保证数据安全
数据卷操作:
- docker volume create:创建数据卷
- docker volume ls:查看所有数据卷
- docker volume inspect:查看数据卷详细信息,包括关联的宿主机目录位置
- docker volume rm:删除指定数据卷
- docker volume prune:删除所有未使用的数据卷
2.3.4.挂载数据卷
我们在创建容器时,可以通过 -v 参数来挂载一个数据卷到某个容器内目录,命令格式如下:
docker run \
  --name mn \
  -v html:/root/html \
  -p 8080:80
  nginx \
这里的-v就是挂载数据卷的命令:
-v html:/root/htm:把html数据卷挂载到容器内的/root/html这个目录中2.3.5.案例-给nginx挂载数据卷
需求:创建一个nginx容器,修改容器内的html目录内的index.html内容
分析:上个案例中,我们进入nginx容器内部,已经知道nginx的html目录所在位置/usr/share/nginx/html ,我们需要把这个目录挂载到html这个数据卷上,方便操作其中的内容。
提示:运行容器时使用 -v 参数挂载数据卷
步骤:
① 创建容器并挂载数据卷到容器内的HTML目录
docker run --name mn -v html:/usr/share/nginx/html -p 80:80 -d nginx② 进入html数据卷所在位置,并修改HTML内容
# 查看html数据卷的位置
docker volume inspect html
# 进入该目录
cd /var/lib/docker/volumes/html/_data
# 修改文件
vi index.html
2.3.6.案例-给MySQL挂载本地目录
容器不仅仅可以挂载数据卷,也可以直接挂载到宿主机目录上。关联关系如下:
- 带数据卷模式:宿主机目录 --> 数据卷 —> 容器内目录
- 直接挂载模式:宿主机目录 —> 容器内目录
如图:
语法:
目录挂载与数据卷挂载的语法是类似的:
- -v [宿主机目录]:[容器内目录]
- -v [宿主机文件]:[容器内文件]
需求:创建并运行一个MySQL容器,将宿主机目录直接挂载到容器
实现思路如下:
1)在将课前资料中的mysql.tar文件上传到虚拟机,通过load命令加载为镜像
2)创建目录/tmp/mysql/data
3)创建目录/tmp/mysql/conf,将课前资料提供的hmy.cnf文件上传到/tmp/mysql/conf
4)去DockerHub查阅资料,创建并运行MySQL容器,要求:
① 挂载/tmp/mysql/data到mysql容器内数据存储目录
② 挂载/tmp/mysql/conf/hmy.cnf到mysql容器的配置文件
③ 设置MySQL密码
2.3.7.小结
docker run的命令中通过 -v 参数挂载文件或目录到容器中:
- -v volume名称:容器内目录
- -v 宿主机文件:容器内文
- -v 宿主机目录:容器内目录
数据卷挂载与目录直接挂载的
- 数据卷挂载耦合度低,由docker来管理目录,但是目录较深,不好找
- 目录挂载耦合度高,需要我们自己管理目录,不过目录容易寻找查看
3.Dockerfile自定义镜像
常见的镜像在DockerHub就能找到,但是我们自己写的项目就必须自己构建镜像了。
而要自定义镜像,就必须先了解镜像的结构才行。
3.1.镜像结构
镜像是将应用程序及其需要的系统函数库、环境、配置、依赖打包而成。
我们以MySQL为例,来看看镜像的组成结构:
简单来说,镜像就是在系统函数库、运行环境基础上,添加应用程序文件、配置文件、依赖文件等组合,然后编写好启动脚本打包在一起形成的文件。
我们要构建镜像,其实就是实现上述打包的过程。
3.2.Dockerfile语法
构建自定义的镜像时,并不需要一个个文件去拷贝,打包。
我们只需要告诉Docker,我们的镜像的组成,需要哪些BaseImage、需要拷贝什么文件、需要安装什么依赖、启动脚本是什么,将来Docker会帮助我们构建镜像。
而描述上述信息的文件就是Dockerfile文件。
Dockerfile就是一个文本文件,其中包含一个个的指令(Instruction) ,用指令来说明要执行什么操作来构建镜像。每一个指令都会形成一层Layer。
更新详细语法说明,请参考官网文档: https://docs.docker.com/engine/reference/builder
3.3.构建Java项目
3.3.1.基于Ubuntu构建Java项目
需求:基于Ubuntu镜像构建一个新镜像,运行一个java项目
步骤1:新建一个空文件夹docker-demo
步骤2:拷贝课前资料中的docker-demo.jar文件到docker-demo这个目录
步骤3:拷贝课前资料中的jdk8.tar.gz文件到docker-demo这个目录
步骤4:拷贝课前资料提供的Dockerfile到docker-demo这个目录
其中的内容如下:
# 指定基础镜像
FROM ubuntu:16.04
# 配置环境变量,JDK的安装目录
ENV JAVA_DIR=/usr/local

# 拷贝jdk和java项目的包
COPY ./jdk8.tar.gz $JAVA_DIR/
COPY ./docker-demo.jar /tmp/app.jar

# 安装JDK
RUN cd $JAVA_DIR \
 && tar -xf ./jdk8.tar.gz \
 && mv ./jdk1.8.0_144 ./java8

# 配置环境变量
ENV JAVA_HOME=$JAVA_DIR/java8
ENV PATH=$PATH:$JAVA_HOME/bin

# 暴露端口
EXPOSE 8090
# 入口,java项目的启动命令
ENTRYPOINT java -jar /tmp/app.jar
步骤5:进入docker-demo
将准备好的docker-demo上传到虚拟机任意目录,然后进入docker-demo目录下
步骤6:运行命令:
docker build -t javaweb:1.0 .最后访问 http://192.168.150.101:8090/hello/count,其中的ip改成你的虚拟机ip
3.3.2.基于java8构建Java项目
虽然我们可以基于Ubuntu基础镜像,添加任意自己需要的安装包,构建镜像,但是却比较麻烦。所以大多数情况下,我们都可以在一些安装了部分软件的基础镜像上做改造。
例如,构建java项目的镜像,可以在已经准备了JDK的基础镜像基础上构建。
需求:基于java:8-alpine镜像,将一个Java项目构建为镜像
实现思路如下:
① 新建一个空的目录,然后在目录中新建一个文件,命名为Dockerfile
② 拷贝课前资料提供的docker-demo.jar到这个目录中
③ 编写Dockerfile文件:
a )基于java:8-alpine作为基础镜像
b )将app.jar拷贝到镜像中
c )暴露端口
d )编写入口ENTRYPOINT
内容如下:
FROM java:8-alpine
COPY ./app.jar /tmp/app.jar
EXPOSE 8090
ENTRYPOINT java -jar /tmp/app.jar
④ 使用docker build命令构建镜像
⑤ 使用docker run创建容器并运行
3.4.小结
小结:
- Dockerfile的本质是一个文件,通过指令描述镜像的构建过程
- Dockerfile的第一行必须是FROM,从一个基础镜像来构建
- 基础镜像可以是基本操作系统,如Ubuntu。也可以是其他人制作好的镜像,例如:java:8-alpine
4.Docker-Compose
Docker Compose可以基于Compose文件帮我们快速的部署分布式应用,而无需手动一个个创建和运行容器!
4.1.初识DockerCompose
Compose文件是一个文本文件,通过指令定义集群中的每个容器如何运行。格式如下:
version: "3.8"
 services:
  mysql:
    image: mysql:5.7.25
    environment:
     MYSQL_ROOT_PASSWORD: 123
    volumes:
     - "/tmp/mysql/data:/var/lib/mysql"
     - "/tmp/mysql/conf/hmy.cnf:/etc/mysql/conf.d/hmy.cnf"
  web:
    build: .
    ports:
     - "8090:8090"
上面的Compose文件就描述一个项目,其中包含两个容器:
- mysql:一个基于
mysql:5.7.25镜像构建的容器,并且挂载了两个目录- web:一个基于
docker build临时构建的镜像容器,映射端口时8090DockerCompose的详细语法参考官网:https://docs.docker.com/compose/compose-file/
其实DockerCompose文件可以看做是将多个docker run命令写到一个文件,只是语法稍有差异。
4.2.安装DockerCompose
参考课前资料
4.3.部署微服务集群
需求:将之前学习的cloud-demo微服务集群利用DockerCompose部署
实现思路:
① 查看课前资料提供的cloud-demo文件夹,里面已经编写好了docker-compose文件
② 修改自己的cloud-demo项目,将数据库、nacos地址都命名为docker-compose中的服务名
③ 使用maven打包工具,将项目中的每个微服务都打包为app.jar
④ 将打包好的app.jar拷贝到cloud-demo中的每一个对应的子目录中
⑤ 将cloud-demo上传至虚拟机,利用 docker-compose up -d 来部署
4.3.1.compose文件
查看课前资料提供的cloud-demo文件夹,里面已经编写好了docker-compose文件,而且每个微服务都准备了一个独立的目录:
内容如下:
version: "3.2"

services:
  nacos:
    image: nacos/nacos-server
    environment:
      MODE: standalone
    ports:
      - "8848:8848"
  mysql:
    image: mysql:5.7.25
    environment:
      MYSQL_ROOT_PASSWORD: 123
    volumes:
      - "$PWD/mysql/data:/var/lib/mysql"
      - "$PWD/mysql/conf:/etc/mysql/conf.d/"
  userservice:
    build: ./user-service
  orderservice:
    build: ./order-service
  gateway:
    build: ./gateway
    ports:
      - "10010:10010"
可以看到,其中包含5个service服务:
nacos:作为注册中心和配置中心
image: nacos/nacos-server: 基于nacos/nacos-server镜像构建environment:环境变量
MODE: standalone:单点模式启动ports:端口映射,这里暴露了8848端口mysql:数据库
image: mysql:5.7.25:镜像版本是mysql:5.7.25environment:环境变量
MYSQL_ROOT_PASSWORD: 123:设置数据库root账户的密码为123volumes:数据卷挂载,这里挂载了mysql的data、conf目录,其中有我提前准备好的数据userservice、orderservice、gateway:都是基于Dockerfile临时构建的查看mysql目录,可以看到其中已经准备好了cloud_order、cloud_user表:
查看微服务目录,可以看到都包含Dockerfile文件:
内容如下:
FROM java:8-alpine
COPY ./app.jar /tmp/app.jar
ENTRYPOINT java -jar /tmp/app.jar
4.3.2.修改微服务配置
因为微服务将来要部署为docker容器,而容器之间互联不是通过IP地址,而是通过容器名。这里我们将order-service、user-service、gateway服务的mysql、nacos地址都修改为基于容器名的访问。
如下所示:
spring:
  datasource:
    url: jdbc:mysql://mysql:3306/cloud_order?useSSL=false
    username: root
    password: 123
    driver-class-name: com.mysql.jdbc.Driver
  application:
    name: orderservice
  cloud:
    nacos:
      server-addr: nacos:8848 # nacos服务地址
4.3.3.打包
接下来需要将我们的每个微服务都打包。因为之前查看到Dockerfile中的jar包名称都是app.jar,因此我们的每个微服务都需要用这个名称。
可以通过修改pom.xml中的打包名称来实现,每个微服务都需要修改:
<build>
  <!-- 服务打包的最终名称 -->
  <finalName>app</finalName>
  <plugins>
    <plugin>
      <groupId>org.springframework.boot</groupId>
      <artifactId>spring-boot-maven-plugin</artifactId>
    </plugin>
  </plugins>
</build>
打包后:
4.3.4.拷贝jar包到部署目录
编译打包好的app.jar文件,需要放到Dockerfile的同级目录中。注意:每个微服务的app.jar放到与服务名称对应的目录,别搞错了。
user-service:
order-service:
gateway:
4.3.5.部署
最后,我们需要将文件整个cloud-demo文件夹上传到虚拟机中,理由DockerCompose部署。
上传到任意目录:
部署:
进入cloud-demo目录,然后运行下面的命令:
docker-compose up -d5.Docker镜像仓库
5.1.搭建私有镜像仓库
参考课前资料《CentOS7安装Docker.md》
5.2.推送、拉取镜像
推送镜像到私有镜像服务必须先tag,步骤如下:
① 重新tag本地镜像,名称前缀为私有仓库的地址:192.168.150.101:8080/
docker tag nginx:latest 192.168.150.101:8080/nginx:1.0② 推送镜像
docker push 192.168.150.101:8080/nginx:1.0③ 拉取镜像
docker pull 192.168.150.101:8080/nginx:1.0


1、Windows安装(单点部署)
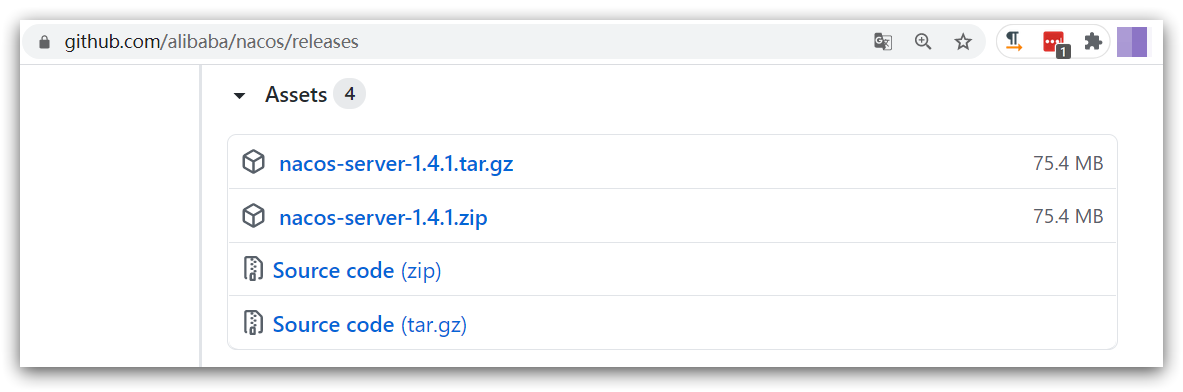
1.1、下载安装包
在Nacos的GitHub页面,提供有下载链接,可以下载编译好的Nacos服务端或者源代码:
**GitHub主页:**https://github.com/alibaba/nacos如图:
我这里是用1.4.1.版本的Nacos,压缩包链接如下:
**链接:**https://pan.baidu.com/s/1ykqimWbU04_w9ymutt9VQw?pwd=0xws
提取码:0xws
–来自百度网盘超级会员V5的分享1.2、解压
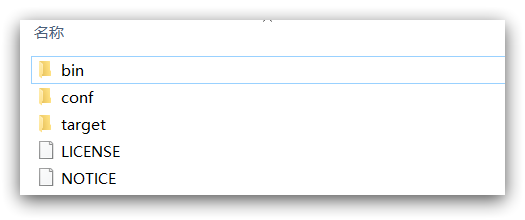
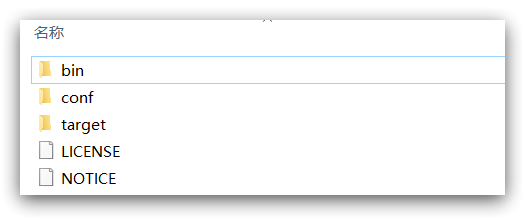
将这个包解压到任意非中文目录下,如图:
目录说明:
- bin:启动脚本
- conf:配置文件
1.3、端口配置
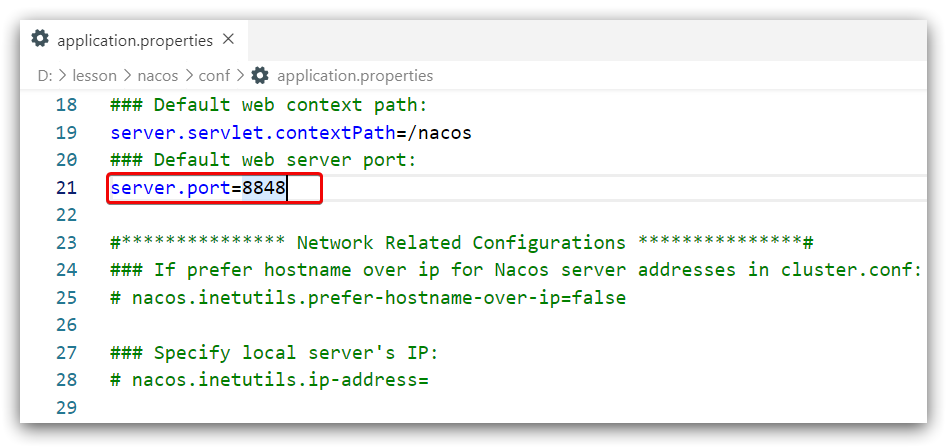
Nacos的默认端口是8848,如果你电脑上的其它进程占用了8848端口,请先尝试关闭该进程。
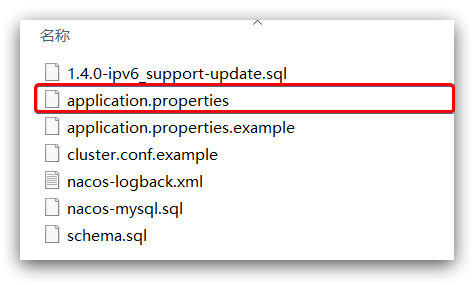
如果无法关闭占用8848端口的进程,也可以进入nacos的conf目录,修改配置文件中的端口:
修改其中的内容:
1.4、启动
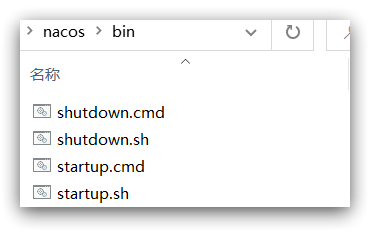
启动非常简单,进入bin目录,结构如下:
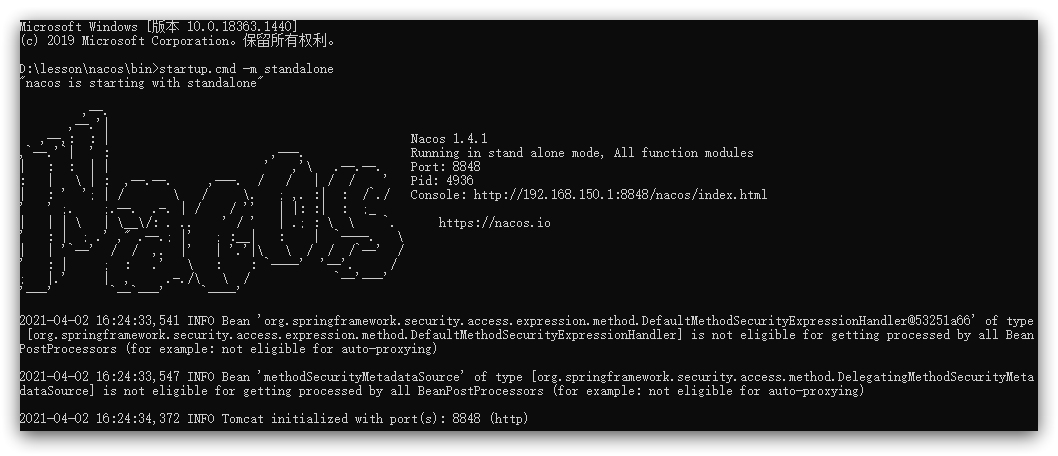
然后执行命令即可:startup.cmd -m standalone执行后的效果如图:
1.5、访问
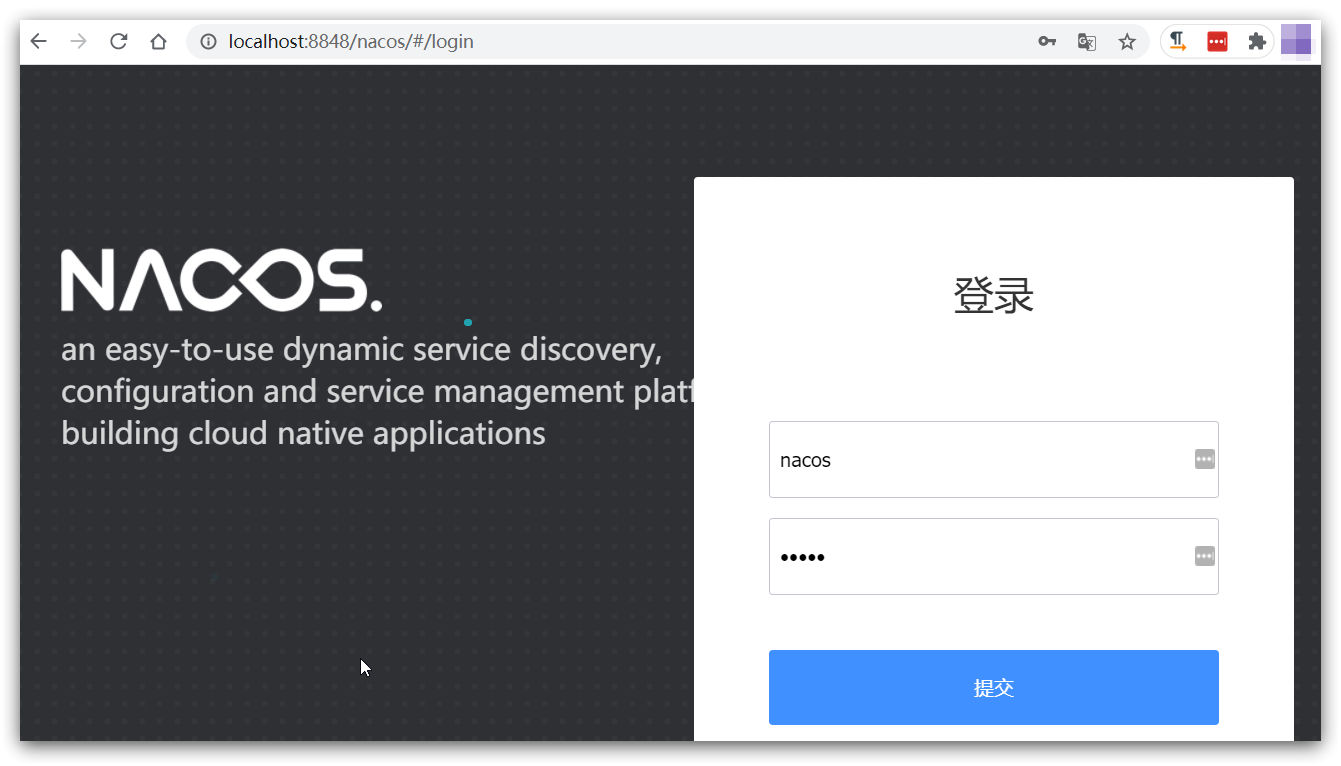
在浏览器输入地址:http://127.0.0.1:8848/nacos即可:
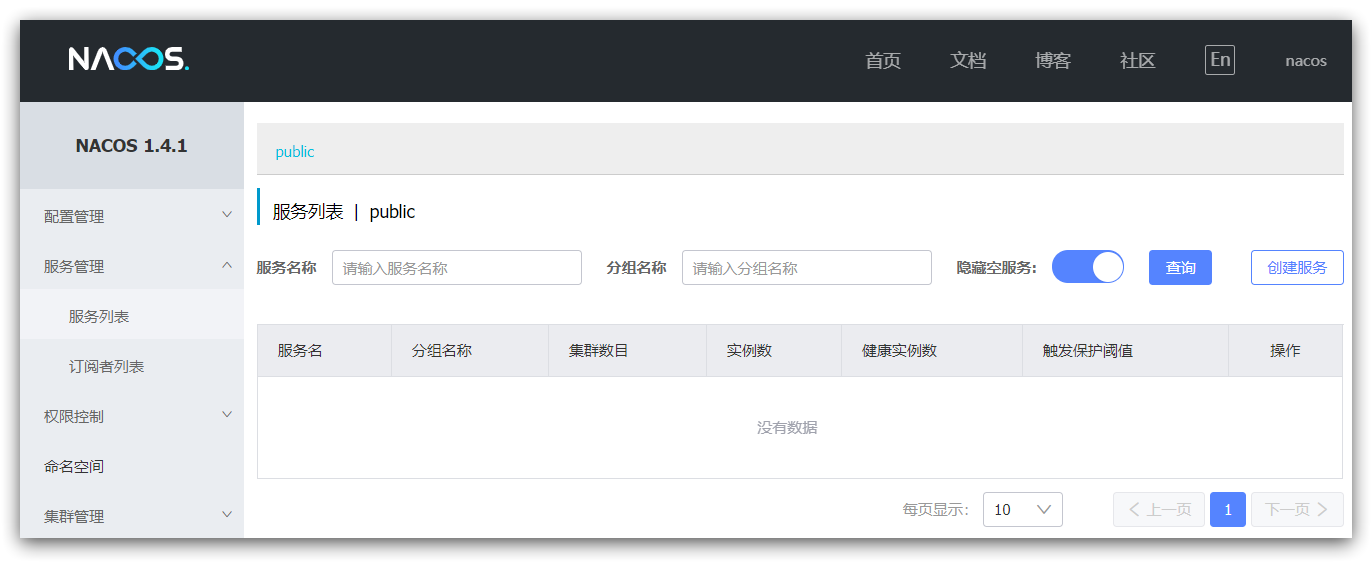
默认的账号和密码都是nacos ,进入后:
2、Linux安装 (单点部署)
Linux或者Mac安装方式与Windows类似。
2.1、安装JDK
Nacos依赖于JDK运行,所以Linux上也需要安装JDK才行。
2.2、上传安装包
压缩包链接如下:
**链接:**https://pan.baidu.com/s/1L9WhrNmwvDVlk_liAuC6WA?pwd=slg0
提取码:slg0
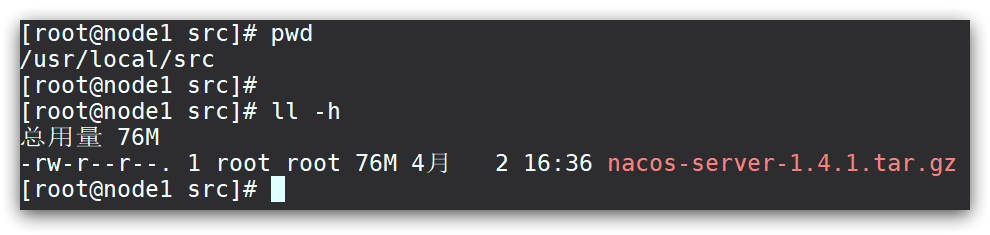
–来自百度网盘超级会员V5的分享上传到Linux服务器的某个目录,例如 /usr/local/src****目录下:
2.3、解压
命令解压缩安装包:
tar -xvf nacos-server-1.4.1.tar.gz然后删除安装包:
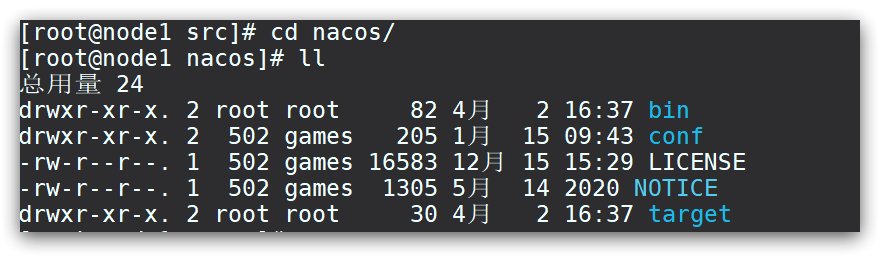
rm -rf nacos-server-1.4.1.tar.gz目录内部:
2.4、端口配置
与windows中类似
2.5、启动
在nacos/bin目录中,输入命令启动Nacos:
sh startup.sh -m standalone3、Nacos的依赖
父工程:
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-alibaba-dependencies</artifactId>
    <version>2.2.5.RELEASE</version>
    <type>pom</type>
    <scope>import</scope>
</dependency>
客户端:
<!-- nacos客户端依赖包 -->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
4、Nacos集群搭建
1、集群结构图
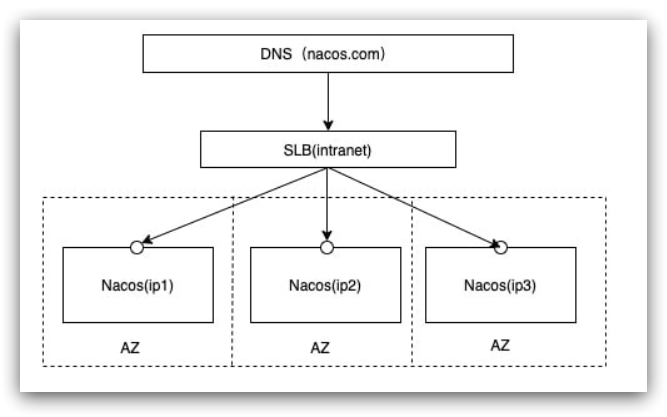
官方给出的Nacos集群图:
其中包含3个nacos节点,然后一个负载均衡器代理3个Nacos。这里负载均衡器可以使用nginx。
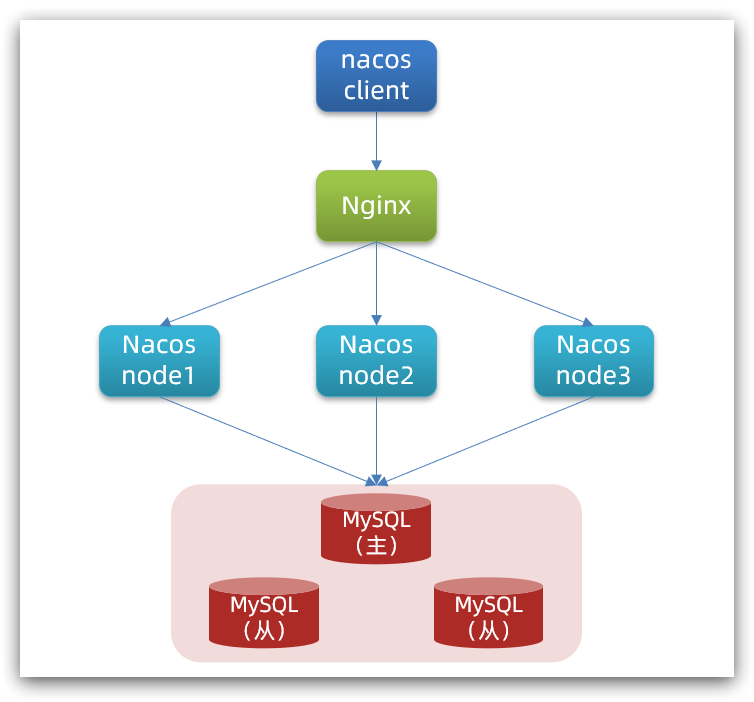
我们计划的集群结构:
三个nacos节点的地址:
节点 ip port nacos1 192.168.150.1 8845 nacos2 192.168.150.1 8846 nacos3 192.168.150.1 8847 2、搭建集群
搭建集群的基本步骤:
- 搭建数据库,初始化数据库表结构
- 下载nacos安装包
- 配置nacos
- 启动nacos集群
- nginx反向代理
2.1、初始化数据库
Nacos默认数据存储在内嵌数据库Derby中,不属于生产可用的数据库。
官方推荐的最佳实践是使用带有主从的高可用数据库集群。
这里我们以单点的数据库为例来讲解。
首先新建一个数据库,命名为nacos,而后导入下面的SQL:CREATE TABLE `config_info` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id', `data_id` varchar(255) NOT NULL COMMENT 'data_id', `group_id` varchar(255) DEFAULT NULL, `content` longtext NOT NULL COMMENT 'content', `md5` varchar(32) DEFAULT NULL COMMENT 'md5', `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', `src_user` text COMMENT 'source user', `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip', `app_name` varchar(128) DEFAULT NULL, `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段', `c_desc` varchar(256) DEFAULT NULL, `c_use` varchar(64) DEFAULT NULL, `effect` varchar(64) DEFAULT NULL, `type` varchar(64) DEFAULT NULL, `c_schema` text, PRIMARY KEY (`id`), UNIQUE KEY `uk_configinfo_datagrouptenant` (`data_id`,`group_id`,`tenant_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = config_info_aggr */ /******************************************/ CREATE TABLE `config_info_aggr` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id', `data_id` varchar(255) NOT NULL COMMENT 'data_id', `group_id` varchar(255) NOT NULL COMMENT 'group_id', `datum_id` varchar(255) NOT NULL COMMENT 'datum_id', `content` longtext NOT NULL COMMENT '内容', `gmt_modified` datetime NOT NULL COMMENT '修改时间', `app_name` varchar(128) DEFAULT NULL, `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段', PRIMARY KEY (`id`), UNIQUE KEY `uk_configinfoaggr_datagrouptenantdatum` (`data_id`,`group_id`,`tenant_id`,`datum_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='增加租户字段'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = config_info_beta */ /******************************************/ CREATE TABLE `config_info_beta` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id', `data_id` varchar(255) NOT NULL COMMENT 'data_id', `group_id` varchar(128) NOT NULL COMMENT 'group_id', `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name', `content` longtext NOT NULL COMMENT 'content', `beta_ips` varchar(1024) DEFAULT NULL COMMENT 'betaIps', `md5` varchar(32) DEFAULT NULL COMMENT 'md5', `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', `src_user` text COMMENT 'source user', `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip', `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段', PRIMARY KEY (`id`), UNIQUE KEY `uk_configinfobeta_datagrouptenant` (`data_id`,`group_id`,`tenant_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info_beta'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = config_info_tag */ /******************************************/ CREATE TABLE `config_info_tag` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id', `data_id` varchar(255) NOT NULL COMMENT 'data_id', `group_id` varchar(128) NOT NULL COMMENT 'group_id', `tenant_id` varchar(128) DEFAULT '' COMMENT 'tenant_id', `tag_id` varchar(128) NOT NULL COMMENT 'tag_id', `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name', `content` longtext NOT NULL COMMENT 'content', `md5` varchar(32) DEFAULT NULL COMMENT 'md5', `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', `src_user` text COMMENT 'source user', `src_ip` varchar(50) DEFAULT NULL COMMENT 'source ip', PRIMARY KEY (`id`), UNIQUE KEY `uk_configinfotag_datagrouptenanttag` (`data_id`,`group_id`,`tenant_id`,`tag_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_info_tag'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = config_tags_relation */ /******************************************/ CREATE TABLE `config_tags_relation` ( `id` bigint(20) NOT NULL COMMENT 'id', `tag_name` varchar(128) NOT NULL COMMENT 'tag_name', `tag_type` varchar(64) DEFAULT NULL COMMENT 'tag_type', `data_id` varchar(255) NOT NULL COMMENT 'data_id', `group_id` varchar(128) NOT NULL COMMENT 'group_id', `tenant_id` varchar(128) DEFAULT '' COMMENT 'tenant_id', `nid` bigint(20) NOT NULL AUTO_INCREMENT, PRIMARY KEY (`nid`), UNIQUE KEY `uk_configtagrelation_configidtag` (`id`,`tag_name`,`tag_type`), KEY `idx_tenant_id` (`tenant_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='config_tag_relation'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = group_capacity */ /******************************************/ CREATE TABLE `group_capacity` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID', `group_id` varchar(128) NOT NULL DEFAULT '' COMMENT 'Group ID,空字符表示整个集群', `quota` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '配额,0表示使用默认值', `usage` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '使用量', `max_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个配置大小上限,单位为字节,0表示使用默认值', `max_aggr_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '聚合子配置最大个数,,0表示使用默认值', `max_aggr_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个聚合数据的子配置大小上限,单位为字节,0表示使用默认值', `max_history_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '最大变更历史数量', `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', PRIMARY KEY (`id`), UNIQUE KEY `uk_group_id` (`group_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='集群、各Group容量信息表'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = his_config_info */ /******************************************/ CREATE TABLE `his_config_info` ( `id` bigint(64) unsigned NOT NULL, `nid` bigint(20) unsigned NOT NULL AUTO_INCREMENT, `data_id` varchar(255) NOT NULL, `group_id` varchar(128) NOT NULL, `app_name` varchar(128) DEFAULT NULL COMMENT 'app_name', `content` longtext NOT NULL, `md5` varchar(32) DEFAULT NULL, `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP, `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP, `src_user` text, `src_ip` varchar(50) DEFAULT NULL, `op_type` char(10) DEFAULT NULL, `tenant_id` varchar(128) DEFAULT '' COMMENT '租户字段', PRIMARY KEY (`nid`), KEY `idx_gmt_create` (`gmt_create`), KEY `idx_gmt_modified` (`gmt_modified`), KEY `idx_did` (`data_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='多租户改造'; /******************************************/ /* 数据库全名 = nacos_config */ /* 表名称 = tenant_capacity */ /******************************************/ CREATE TABLE `tenant_capacity` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID', `tenant_id` varchar(128) NOT NULL DEFAULT '' COMMENT 'Tenant ID', `quota` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '配额,0表示使用默认值', `usage` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '使用量', `max_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个配置大小上限,单位为字节,0表示使用默认值', `max_aggr_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '聚合子配置最大个数', `max_aggr_size` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '单个聚合数据的子配置大小上限,单位为字节,0表示使用默认值', `max_history_count` int(10) unsigned NOT NULL DEFAULT '0' COMMENT '最大变更历史数量', `gmt_create` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间', `gmt_modified` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '修改时间', PRIMARY KEY (`id`), UNIQUE KEY `uk_tenant_id` (`tenant_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='租户容量信息表'; CREATE TABLE `tenant_info` ( `id` bigint(20) NOT NULL AUTO_INCREMENT COMMENT 'id', `kp` varchar(128) NOT NULL COMMENT 'kp', `tenant_id` varchar(128) default '' COMMENT 'tenant_id', `tenant_name` varchar(128) default '' COMMENT 'tenant_name', `tenant_desc` varchar(256) DEFAULT NULL COMMENT 'tenant_desc', `create_source` varchar(32) DEFAULT NULL COMMENT 'create_source', `gmt_create` bigint(20) NOT NULL COMMENT '创建时间', `gmt_modified` bigint(20) NOT NULL COMMENT '修改时间', PRIMARY KEY (`id`), UNIQUE KEY `uk_tenant_info_kptenantid` (`kp`,`tenant_id`), KEY `idx_tenant_id` (`tenant_id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COLLATE=utf8_bin COMMENT='tenant_info'; CREATE TABLE `users` ( `username` varchar(50) NOT NULL PRIMARY KEY, `password` varchar(500) NOT NULL, `enabled` boolean NOT NULL ); CREATE TABLE `roles` ( `username` varchar(50) NOT NULL, `role` varchar(50) NOT NULL, UNIQUE INDEX `idx_user_role` (`username` ASC, `role` ASC) USING BTREE ); CREATE TABLE `permissions` ( `role` varchar(50) NOT NULL, `resource` varchar(255) NOT NULL, `action` varchar(8) NOT NULL, UNIQUE INDEX `uk_role_permission` (`role`,`resource`,`action`) USING BTREE ); INSERT INTO users (username, password, enabled) VALUES ('nacos', '$2a$10$EuWPZHzz32dJN7jexM34MOeYirDdFAZm2kuWj7VEOJhhZkDrxfvUu', TRUE); INSERT INTO roles (username, role) VALUES ('nacos', 'ROLE_ADMIN');2.2、下载nacos
**nacos在GitHub上有下载地址:**https://github.com/alibaba/nacos/tags ,可以选择任意版本下载。
本例中采用1.4.1版本,下载链接如下:
**链接:**https://pan.baidu.com/s/1ykqimWbU04_w9ymutt9VQw?pwd=0xws
提取码:0xws
–来自百度网盘超级会员V5的分享2.3、配置Nacos
将这个包解压到任意非中文目录下,如图:
目录说明:
- bin:启动脚本
- conf:配置文件
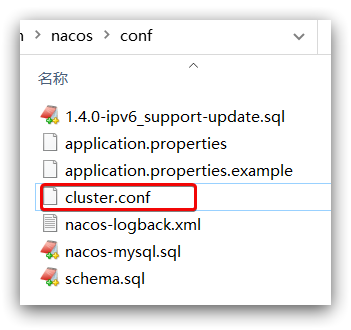
进入nacos的conf目录,修改配置文件cluster.conf.example ,重命名为cluster.conf :
然后添加内容:127.0.0.1:8845 127.0.0.1.8846 127.0.0.1.8847然后修改application.properties文件,添加数据库配置
spring.datasource.platform=mysql db.num=1 db.url.0=jdbc:mysql://127.0.0.1:3306/nacos?characterEncoding=utf8&connectTimeout=1000&socketTimeout=3000&autoReconnect=true&useUnicode=true&useSSL=false&serverTimezone=UTC db.user.0=root db.password.0=1234562.4、启动
将nacos文件夹复制三份,分别命名为:nacos1、nacos2、nacos3
然后分别修改三个文件夹中的application.properties ,
nacos1:server.port=8845nacos2:
server.port=8846nacos3:
server.port=8847然后分别启动三个nacos节点:
startup.cmd2.5、nginx反向代理
nginx安装包下载链接: **
链接:https://pan.baidu.com/s/1Karw3BL4fau3LgRvs7GoFw?pwd=denb
提取码:denb
–来自百度网盘超级会员V5的分享
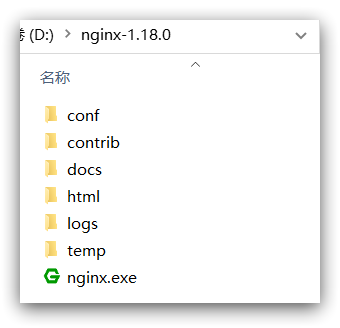
解压到任意非中文目录下:
修改conf/nginx.conf**文件,配置如下:upstream nacos-cluster { server 127.0.0.1:8845; server 127.0.0.1:8846; server 127.0.0.1:8847; } server { listen 80; server_name localhost; location /nacos { } }而后在浏览器访问:http://localhost/nacos即可。
代码中application.yml文件配置如下:spring: cloud: nacos: server-addr: localhost:80 # Nacos地址2.6、优化
- 实际部署时,需要给做反向代理的nginx服务器设置一个域名,这样后续如果有服务器迁移nacos的客户端也无需更改配置.
1.初识MQ
1.1.同步和异步通讯
微服务间通讯有同步和异步两种方式:
同步通讯:就像打电话,需要实时响应。
异步通讯:就像发邮件,不需要马上回复。
两种方式各有优劣,打电话可以立即得到响应,但是你却不能跟多个人同时通话。发送邮件可以同时与多个人收发邮件,但是往往响应会有延迟。
1.1.1.同步通讯
我们之前学习的Feign调用就属于同步方式,虽然调用可以实时得到结果,但存在下面的问题:
总结:
同步调用的优点:
- 时效性较强,可以立即得到结果
同步调用的问题:
- 耦合度高
- 性能和吞吐能力下降
- 有额外的资源消耗
- 有级联失败问题
1.1.2.异步通讯
异步调用则可以避免上述问题:
我们以购买商品为例,用户支付后需要调用订单服务完成订单状态修改,调用物流服务,从仓库分配响应的库存并准备发货。
在事件模式中,支付服务是事件发布者(publisher),在支付完成后只需要发布一个支付成功的事件(event),事件中带上订单id。
订单服务和物流服务是事件订阅者(Consumer),订阅支付成功的事件,监听到事件后完成自己业务即可。
为了解除事件发布者与订阅者之间的耦合,两者并不是直接通信,而是有一个中间人(Broker)。发布者发布事件到Broker,不关心谁来订阅事件。订阅者从Broker订阅事件,不关心谁发来的消息。
Broker 是一个像数据总线一样的东西,所有的服务要接收数据和发送数据都发到这个总线上,这个总线就像协议一样,让服务间的通讯变得标准和可控。
好处:
- 吞吐量提升:无需等待订阅者处理完成,响应更快速
- 故障隔离:服务没有直接调用,不存在级联失败问题
- 调用间没有阻塞,不会造成无效的资源占用
- 耦合度极低,每个服务都可以灵活插拔,可替换
- 流量削峰:不管发布事件的流量波动多大,都由Broker接收,订阅者可以按照自己的速度去处理事件
缺点:
- 架构复杂了,业务没有明显的流程线,不好管理
- 需要依赖于Broker的可靠、安全、性能
好在现在开源软件或云平台上 Broker 的软件是非常成熟的,比较常见的一种就是我们今天要学习的MQ技术。
1.2.技术对比:
MQ,中文是消息队列(MessageQueue),字面来看就是存放消息的队列。也就是事件驱动架构中的Broker。
比较常见的MQ实现:
- ActiveMQ
- RabbitMQ
- RocketMQ
- Kafka
几种常见MQ的对比:
RabbitMQ ActiveMQ RocketMQ Kafka 公司/社区 Rabbit Apache 阿里 Apache 开发语言 Erlang Java Java Scala&Java 协议支持 AMQP,XMPP,SMTP,STOMP OpenWire,STOMP,REST,XMPP,AMQP 自定义协议 自定义协议 可用性 高 一般 高 高 单机吞吐量 一般 差 高 非常高 消息延迟 微秒级 毫秒级 毫秒级 毫秒以内 消息可靠性 高 一般 高 一般 追求可用性:Kafka、 RocketMQ 、RabbitMQ
追求可靠性:RabbitMQ、RocketMQ
追求吞吐能力:RocketMQ、Kafka
追求消息低延迟:RabbitMQ、Kafka
2.快速入门
2.1.安装RabbitMQ
安装RabbitMQ,参考课前资料:
MQ的基本结构:
RabbitMQ中的一些角色:
- publisher:生产者
- consumer:消费者
- exchange个:交换机,负责消息路由
- queue:队列,存储消息
- virtualHost:虚拟主机,隔离不同租户的exchange、queue、消息的隔离
2.2.RabbitMQ消息模型
RabbitMQ官方提供了5个不同的Demo示例,对应了不同的消息模型:
2.3.导入Demo工程
课前资料提供了一个Demo工程,mq-demo:
导入后可以看到结构如下:
包括三部分:
- mq-demo:父工程,管理项目依赖
- publisher:消息的发送者
- consumer:消息的消费者
2.4.入门案例
简单队列模式的模型图:
官方的HelloWorld是基于最基础的消息队列模型来实现的,只包括三个角色:
- publisher:消息发布者,将消息发送到队列queue
- queue:消息队列,负责接受并缓存消息
- consumer:订阅队列,处理队列中的消息
2.4.1.publisher实现
思路:
- 建立连接
- 创建Channel
- 声明队列
- 发送消息
- 关闭连接和channel
代码实现:
package cn.itcast.mq.helloworld;

import com.rabbitmq.client.Channel;
import com.rabbitmq.client.Connection;
import com.rabbitmq.client.ConnectionFactory;
import org.junit.Test;

import java.io.IOException;
import java.util.concurrent.TimeoutException;

public class PublisherTest {
    @Test
    public void testSendMessage() throws IOException, TimeoutException {
        // 1.建立连接
        ConnectionFactory factory = new ConnectionFactory();
        // 1.1.设置连接参数,分别是:主机名、端口号、vhost、用户名、密码
        factory.setHost("192.168.150.101");
        factory.setPort(5672);
        factory.setVirtualHost("/");
        factory.setUsername("itcast");
        factory.setPassword("123321");
        // 1.2.建立连接
        Connection connection = factory.newConnection();

        // 2.创建通道Channel
        Channel channel = connection.createChannel();

        // 3.创建队列
        String queueName = "simple.queue";
        channel.queueDeclare(queueName, false, false, false, null);

        // 4.发送消息
        String message = "hello, rabbitmq!";
        channel.basicPublish("", queueName, null, message.getBytes());
        System.out.println("发送消息成功:【" + message + "】");

        // 5.关闭通道和连接
        channel.close();
        connection.close();

    }
}
2.4.2.consumer实现
代码思路:
- 建立连接
- 创建Channel
- 声明队列
- 订阅消息
代码实现:
package cn.itcast.mq.helloworld;

import com.rabbitmq.client.*;

import java.io.IOException;
import java.util.concurrent.TimeoutException;

public class ConsumerTest {

    public static void main(String[] args) throws IOException, TimeoutException {
        // 1.建立连接
        ConnectionFactory factory = new ConnectionFactory();
        // 1.1.设置连接参数,分别是:主机名、端口号、vhost、用户名、密码
        factory.setHost("192.168.150.101");
        factory.setPort(5672);
        factory.setVirtualHost("/");
        factory.setUsername("itcast");
        factory.setPassword("123321");
        // 1.2.建立连接
        Connection connection = factory.newConnection();

        // 2.创建通道Channel
        Channel channel = connection.createChannel();

        // 3.创建队列
        String queueName = "simple.queue";
        channel.queueDeclare(queueName, false, false, false, null);

        // 4.订阅消息
        channel.basicConsume(queueName, true, new DefaultConsumer(channel){
            @Override
            public void handleDelivery(String consumerTag, Envelope envelope,
                                       AMQP.BasicProperties properties, byte[] body) throws IOException {
                // 5.处理消息
                String message = new String(body);
                System.out.println("接收到消息:【" + message + "】");
            }
        });
        System.out.println("等待接收消息。。。。");
    }
}
2.5.总结
基本消息队列的消息发送流程:
- 建立connection
- 创建channel
- 利用channel声明队列
- 利用channel向队列发送消息
基本消息队列的消息接收流程:
- 建立connection
- 创建channel
- 利用channel声明队列
- 定义consumer的消费行为handleDelivery()
- 利用channel将消费者与队列绑定
3.SpringAMQP
SpringAMQP是基于RabbitMQ封装的一套模板,并且还利用SpringBoot对其实现了自动装配,使用起来非常方便。
SpringAmqp的官方地址:https://spring.io/projects/spring-amqp
SpringAMQP提供了三个功能:
- 自动声明队列、交换机及其绑定关系
- 基于注解的监听器模式,异步接收消息
- 封装了RabbitTemplate工具,用于发送消息
3.1.Basic Queue 简单队列模型
在父工程mq-demo中引入依赖
<!--AMQP依赖,包含RabbitMQ-->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
3.1.1.消息发送
首先配置MQ地址,在publisher服务的application.yml中添加配置:
spring:
  rabbitmq:
    host: 192.168.150.101 # 主机名
    port: 5672 # 端口
    virtual-host: / # 虚拟主机
    username: itcast # 用户名
    password: 123321 # 密码
然后在publisher服务中编写测试类SpringAmqpTest,并利用RabbitTemplate实现消息发送:
package cn.itcast.mq.spring;

import org.junit.Test;
import org.junit.runner.RunWith;
import org.springframework.amqp.rabbit.core.RabbitTemplate;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.test.context.junit4.SpringRunner;

@RunWith(SpringRunner.class)
@SpringBootTest
public class SpringAmqpTest {

    @Autowired
    private RabbitTemplate rabbitTemplate;

    @Test
    public void testSimpleQueue() {
        // 队列名称
        String queueName = "simple.queue";
        // 消息
        String message = "hello, spring amqp!";
        // 发送消息
        rabbitTemplate.convertAndSend(queueName, message);
    }
}
3.1.2.消息接收
首先配置MQ地址,在consumer服务的application.yml中添加配置:
spring:
  rabbitmq:
    host: 192.168.150.101 # 主机名
    port: 5672 # 端口
    virtual-host: / # 虚拟主机
    username: itcast # 用户名
    password: 123321 # 密码
然后在consumer服务的
cn.itcast.mq.listener包中新建一个类SpringRabbitListener,代码如下:package cn.itcast.mq.listener; import org.springframework.amqp.rabbit.annotation.RabbitListener; import org.springframework.stereotype.Component; @Component public class SpringRabbitListener { @RabbitListener(queues = "simple.queue") public void listenSimpleQueueMessage(String msg) throws InterruptedException { System.out.println("spring 消费者接收到消息:【" + msg + "】"); } }3.1.3.测试
启动consumer服务,然后在publisher服务中运行测试代码,发送MQ消息
3.2.WorkQueue
Work queues,也被称为(Task queues),任务模型。简单来说就是让多个消费者绑定到一个队列,共同消费队列中的消息。
当消息处理比较耗时的时候,可能生产消息的速度会远远大于消息的消费速度。长此以往,消息就会堆积越来越多,无法及时处理。
此时就可以使用work 模型,多个消费者共同处理消息处理,速度就能大大提高了。
3.2.1.消息发送
这次我们循环发送,模拟大量消息堆积现象。
在publisher服务中的SpringAmqpTest类中添加一个测试方法:
/**
     * workQueue
     * 向队列中不停发送消息,模拟消息堆积。
     */
@Test
public void testWorkQueue() throws InterruptedException {
    // 队列名称
    String queueName = "simple.queue";
    // 消息
    String message = "hello, message_";
    for (int i = 0; i < 50; i++) {
        // 发送消息
        rabbitTemplate.convertAndSend(queueName, message + i);
        Thread.sleep(20);
    }
}
3.2.2.消息接收
要模拟多个消费者绑定同一个队列,我们在consumer服务的SpringRabbitListener中添加2个新的方法:
@RabbitListener(queues = "simple.queue")
public void listenWorkQueue1(String msg) throws InterruptedException {
    System.out.println("消费者1接收到消息:【" + msg + "】" + LocalTime.now());
    Thread.sleep(20);
}

@RabbitListener(queues = "simple.queue")
public void listenWorkQueue2(String msg) throws InterruptedException {
    System.err.println("消费者2........接收到消息:【" + msg + "】" + LocalTime.now());
    Thread.sleep(200);
}
注意到这个消费者sleep了1000秒,模拟任务耗时。
3.2.3.测试
启动ConsumerApplication后,在执行publisher服务中刚刚编写的发送测试方法testWorkQueue。
可以看到消费者1很快完成了自己的25条消息。消费者2却在缓慢的处理自己的25条消息。
也就是说消息是平均分配给每个消费者,并没有考虑到消费者的处理能力。这样显然是有问题的。
3.2.4.能者多劳
在spring中有一个简单的配置,可以解决这个问题。我们修改consumer服务的application.yml文件,添加配置:
spring:
  rabbitmq:
    listener:
      simple:
        prefetch: 1 # 每次只能获取一条消息,处理完成才能获取下一个消息
3.2.5.总结
Work模型的使用:
- 多个消费者绑定到一个队列,同一条消息只会被一个消费者处理
- 通过设置prefetch来控制消费者预取的消息数量
3.3.发布/订阅
发布订阅的模型如图:
可以看到,在订阅模型中,多了一个exchange角色,而且过程略有变化:
- Publisher:生产者,也就是要发送消息的程序,但是不再发送到队列中,而是发给X(交换机)
- Exchange:交换机,图中的X。一方面,接收生产者发送的消息。另一方面,知道如何处理消息,例如递交给某个特别队列、递交给所有队列、或是将消息丢弃。到底如何操作,取决于Exchange的类型。Exchange有以下3种类型:
- Fanout:广播,将消息交给所有绑定到交换机的队列
- Direct:定向,把消息交给符合指定routing key 的队列
- Topic:通配符,把消息交给符合routing pattern(路由模式) 的队列
- Consumer:消费者,与以前一样,订阅队列,没有变化
- Queue:消息队列也与以前一样,接收消息、缓存消息。
Exchange(交换机)只负责转发消息,不具备存储消息的能力,因此如果没有任何队列与Exchange绑定,或者没有符合路由规则的队列,那么消息会丢失!
3.4.Fanout
Fanout,英文翻译是扇出,我觉得在MQ中叫广播更合适。
在广播模式下,消息发送流程是这样的:
- 1) 可以有多个队列
- 2) 每个队列都要绑定到Exchange(交换机)
- 3) 生产者发送的消息,只能发送到交换机,交换机来决定要发给哪个队列,生产者无法决定
- 4) 交换机把消息发送给绑定过的所有队列
- 5) 订阅队列的消费者都能拿到消息
我们的计划是这样的:
创建一个交换机 itcast.fanout,类型是Fanout
创建两个队列fanout.queue1和fanout.queue2,绑定到交换机itcast.fanout
3.4.1.声明队列和交换机
Spring提供了一个接口Exchange,来表示所有不同类型的交换机:
在consumer中创建一个类,声明队列和交换机:
package cn.itcast.mq.config;

import org.springframework.amqp.core.Binding;
import org.springframework.amqp.core.BindingBuilder;
import org.springframework.amqp.core.FanoutExchange;
import org.springframework.amqp.core.Queue;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class FanoutConfig {
    /**
     * 声明交换机
     * @return Fanout类型交换机
     */
    @Bean
    public FanoutExchange fanoutExchange(){
        return new FanoutExchange("itcast.fanout");
    }

    /**
     * 第1个队列
     */
    @Bean
    public Queue fanoutQueue1(){
        return new Queue("fanout.queue1");
    }

    /**
     * 绑定队列和交换机
     */
    @Bean
    public Binding bindingQueue1(Queue fanoutQueue1, FanoutExchange fanoutExchange){
        return BindingBuilder.bind(fanoutQueue1).to(fanoutExchange);
    }

    /**
     * 第2个队列
     */
    @Bean
    public Queue fanoutQueue2(){
        return new Queue("fanout.queue2");
    }

    /**
     * 绑定队列和交换机
     */
    @Bean
    public Binding bindingQueue2(Queue fanoutQueue2, FanoutExchange fanoutExchange){
        return BindingBuilder.bind(fanoutQueue2).to(fanoutExchange);
    }
}
3.4.2.消息发送
在publisher服务的SpringAmqpTest类中添加测试方法:
@Test
public void testFanoutExchange() {
    // 队列名称
    String exchangeName = "itcast.fanout";
    // 消息
    String message = "hello, everyone!";
    rabbitTemplate.convertAndSend(exchangeName, "", message);
}
3.4.3.消息接收
在consumer服务的SpringRabbitListener中添加两个方法,作为消费者:
@RabbitListener(queues = "fanout.queue1")
public void listenFanoutQueue1(String msg) {
    System.out.println("消费者1接收到Fanout消息:【" + msg + "】");
}

@RabbitListener(queues = "fanout.queue2")
public void listenFanoutQueue2(String msg) {
    System.out.println("消费者2接收到Fanout消息:【" + msg + "】");
}
3.4.4.总结
交换机的作用是什么?
- 接收publisher发送的消息
- 将消息按照规则路由到与之绑定的队列
- 不能缓存消息,路由失败,消息丢失
- FanoutExchange的会将消息路由到每个绑定的队列
声明队列、交换机、绑定关系的Bean是什么?
- Queue
- FanoutExchange
- Binding
3.5.Direct
在Fanout模式中,一条消息,会被所有订阅的队列都消费。但是,在某些场景下,我们希望不同的消息被不同的队列消费。这时就要用到Direct类型的Exchange。
在Direct模型下:
- 队列与交换机的绑定,不能是任意绑定了,而是要指定一个
RoutingKey(路由key)- 消息的发送方在 向 Exchange发送消息时,也必须指定消息的
RoutingKey。- Exchange不再把消息交给每一个绑定的队列,而是根据消息的
Routing Key进行判断,只有队列的Routingkey与消息的Routing key完全一致,才会接收到消息案例需求如下:
利用@RabbitListener声明Exchange、Queue、RoutingKey
在consumer服务中,编写两个消费者方法,分别监听direct.queue1和direct.queue2
在publisher中编写测试方法,向itcast. direct发送消息
3.5.1.基于注解声明队列和交换机
基于@Bean的方式声明队列和交换机比较麻烦,Spring还提供了基于注解方式来声明。
在consumer的SpringRabbitListener中添加两个消费者,同时基于注解来声明队列和交换机:
@RabbitListener(bindings = @QueueBinding(
    value = @Queue(name = "direct.queue1"),
    exchange = @Exchange(name = "itcast.direct", type = ExchangeTypes.DIRECT),
    key = {"red", "blue"}
))
public void listenDirectQueue1(String msg){
    System.out.println("消费者接收到direct.queue1的消息:【" + msg + "】");
}

@RabbitListener(bindings = @QueueBinding(
    value = @Queue(name = "direct.queue2"),
    exchange = @Exchange(name = "itcast.direct", type = ExchangeTypes.DIRECT),
    key = {"red", "yellow"}
))
public void listenDirectQueue2(String msg){
    System.out.println("消费者接收到direct.queue2的消息:【" + msg + "】");
}
3.5.2.消息发送
在publisher服务的SpringAmqpTest类中添加测试方法:
@Test
public void testSendDirectExchange() {
    // 交换机名称
    String exchangeName = "itcast.direct";
    // 消息
    String message = "红色警报!日本乱排核废水,导致海洋生物变异,惊现哥斯拉!";
    // 发送消息
    rabbitTemplate.convertAndSend(exchangeName, "red", message);
}
3.5.3.总结
描述下Direct交换机与Fanout交换机的差异?
- Fanout交换机将消息路由给每一个与之绑定的队列
- Direct交换机根据RoutingKey判断路由给哪个队列
- 如果多个队列具有相同的RoutingKey,则与Fanout功能类似
基于@RabbitListener注解声明队列和交换机有哪些常见注解?
- @Queue
- @Exchange
3.6.Topic
3.6.1.说明
Topic类型的Exchange与Direct相比,都是可以根据RoutingKey把消息路由到不同的队列。只不过Topic类型Exchange可以让队列在绑定Routing key的时候使用通配符!
Routingkey一般都是有一个或多个单词组成,多个单词之间以”.”分割,例如:item.insert通配符规则:
#:匹配一个或多个词
*:匹配不多不少恰好1个词举例:
item.#:能够匹配item.spu.insert或者item.spu
item.*:只能匹配item.spu图示:
解释:
- Queue1:绑定的是
china.#,因此凡是以china.开头的routing key都会被匹配到。包括china.news和china.weather- Queue2:绑定的是
#.news,因此凡是以.news结尾的routing key都会被匹配。包括china.news和japan.news案例需求:
实现思路如下:
并利用@RabbitListener声明Exchange、Queue、RoutingKey
在consumer服务中,编写两个消费者方法,分别监听topic.queue1和topic.queue2
在publisher中编写测试方法,向itcast. topic发送消息
3.6.2.消息发送
在publisher服务的SpringAmqpTest类中添加测试方法:
/**
     * topicExchange
     */
@Test
public void testSendTopicExchange() {
    // 交换机名称
    String exchangeName = "itcast.topic";
    // 消息
    String message = "喜报!孙悟空大战哥斯拉,胜!";
    // 发送消息
    rabbitTemplate.convertAndSend(exchangeName, "china.news", message);
}
3.6.3.消息接收
在consumer服务的SpringRabbitListener中添加方法:
@RabbitListener(bindings = @QueueBinding(
    value = @Queue(name = "topic.queue1"),
    exchange = @Exchange(name = "itcast.topic", type = ExchangeTypes.TOPIC),
    key = "china.#"
))
public void listenTopicQueue1(String msg){
    System.out.println("消费者接收到topic.queue1的消息:【" + msg + "】");
}

@RabbitListener(bindings = @QueueBinding(
    value = @Queue(name = "topic.queue2"),
    exchange = @Exchange(name = "itcast.topic", type = ExchangeTypes.TOPIC),
    key = "#.news"
))
public void listenTopicQueue2(String msg){
    System.out.println("消费者接收到topic.queue2的消息:【" + msg + "】");
}
3.6.4.总结
描述下Direct交换机与Topic交换机的差异?
- Topic交换机接收的消息RoutingKey必须是多个单词,以
**.**分割- Topic交换机与队列绑定时的bindingKey可以指定通配符
#:代表0个或多个词*:代表1个词3.7.消息转换器
之前说过,Spring会把你发送的消息序列化为字节发送给MQ,接收消息的时候,还会把字节反序列化为Java对象。
只不过,默认情况下Spring采用的序列化方式是JDK序列化。众所周知,JDK序列化存在下列问题:
- 数据体积过大
- 有安全漏洞
- 可读性差
我们来测试一下。
3.7.1.测试默认转换器
我们修改消息发送的代码,发送一个Map对象:
@Test
public void testSendMap() throws InterruptedException {
    // 准备消息
    Map<String,Object> msg = new HashMap<>();
    msg.put("name", "Jack");
    msg.put("age", 21);
    // 发送消息
    rabbitTemplate.convertAndSend("simple.queue","", msg);
}
停止consumer服务
发送消息后查看控制台:
3.7.2.配置JSON转换器
显然,JDK序列化方式并不合适。我们希望消息体的体积更小、可读性更高,因此可以使用JSON方式来做序列化和反序列化。
在publisher和consumer两个服务中都引入依赖:
<dependency>
    <groupId>com.fasterxml.jackson.dataformat</groupId>
    <artifactId>jackson-dataformat-xml</artifactId>
    <version>2.9.10</version>
</dependency>
配置消息转换器。
在启动类中添加一个Bean即可:
@Bean
public MessageConverter jsonMessageConverter(){
    return new Jackson2JsonMessageConverter();
}


1、单机部署
我们在Centos7虚拟机中使用Docker来安装。
1.1、下载镜像
方式一:在线拉取
docker pull rabbitmq:3-management方式二:从本地加载
镜像包下载链接:
**链接:**https://pan.baidu.com/s/1soGiZ_H8KdHvIQOqIKnPrg?pwd=ul7h
提取码:ul7h
–来自百度网盘超级会员V5的分享
上传到虚拟机中后,使用命令加载镜像即可:docker load -i mq.tar1.2、安装MQ
执行下面的命令来运行MQ容器:
docker run \
 -e RABBITMQ_DEFAULT_USER=itcast \
 -e RABBITMQ_DEFAULT_PASS=123321 \
 --name mq \
 --hostname mq1 \
 -p 15672:15672 \
 -p 5672:5672 \
 -d \
 rabbitmq:3-management
2、集群部署
2.1、集群分类
在RabbitMQ的官方文档中,讲述了两种集群的配置方式:
- 普通模式:普通模式集群不进行数据同步,每个MQ都有自己的队列、数据信息(其它元数据信息如交换机等会同步)。例如我们有2个MQ:mq1,和mq2,如果你的消息在mq1,而你连接到了mq2,那么mq2会去mq1拉取消息,然后返回给你。如果mq1宕机,消息就会丢失。
- 镜像模式:与普通模式不同,队列会在各个mq的镜像节点之间同步,因此你连接到任何一个镜像节点,均可获取到消息。而且如果一个节点宕机,并不会导致数据丢失。不过,这种方式增加了数据同步的带宽消耗。
我们先来看普通模式集群。2.2、设置网络
首先,我们需要让3台MQ互相知道对方的存在。
分别在3台机器中,设置 /etc/hosts文件 ,添加如下内容:192.168.150.101 mq1 192.168.150.102 mq2 192.168.150.103 mq3并在每台机器上测试,是否可以ping通对方.
1.认识微服务
1.1.单体架构
单体架构:将业务的所有功能集中在一个项目中开发,打成一个包部署。
单体架构的优缺点如下:
优点:
- 架构简单
- 部署成本低
缺点:
- 耦合度高(维护困难、升级困难)
1.2.分布式架构
分布式架构:根据业务功能对系统做拆分,每个业务功能模块作为独立项目开发,称为一个服务。
分布式架构的优缺点:
优点:
- 降低服务耦合
- 有利于服务升级和拓展
缺点:
- 服务调用关系错综复杂
分布式架构虽然降低了服务耦合,但是服务拆分时也有很多问题需要思考:
- 服务拆分的粒度如何界定?
- 服务之间如何调用?
- 服务的调用关系如何管理?
人们需要制定一套行之有效的标准来约束分布式架构。
1.3.微服务
微服务的架构特征:
单一职责:微服务拆分粒度更小,每一个服务都对应唯一的业务能力,做到单一职责
自治:团队独立、技术独立、数据独立,独立部署和交付
面向服务:服务提供统一标准的接口,与语言和技术无关
隔离性强:服务调用做好隔离、容错、降级,避免出现级联问题
微服务的上述特性其实是在给分布式架构制定一个标准,进一步降低服务之间的耦合度,提供服务的独立性和灵活性。做到高内聚,低耦合。
因此,可以认为微服务是一种经过良好架构设计的分布式架构方案 。
但方案该怎么落地?选用什么样的技术栈?全球的互联网公司都在积极尝试自己的微服务落地方案。
其中在Java领域最引人注目的就是SpringCloud提供的方案了。
1.4.SpringCloud
SpringCloud是目前国内使用最广泛的微服务框架。官网地址:https://spring.io/projects/spring-cloud。
SpringCloud集成了各种微服务功能组件,并基于SpringBoot实现了这些组件的自动装配,从而提供了良好的开箱即用体验。
其中常见的组件包括:
另外,SpringCloud底层是依赖于SpringBoot的,并且有版本的兼容关系,如下:
我们课堂学习的版本是 Hoxton.SR10,因此对应的SpringBoot版本是2.3.x版本。
1.5.总结
单体架构:简单方便,高度耦合,扩展性差,适合小型项目。例如:学生管理系统
分布式架构:松耦合,扩展性好,但架构复杂,难度大。适合大型互联网项目,例如:京东、淘宝
微服务:一种良好的分布式架构方案
①优点:拆分粒度更小、服务更独立、耦合度更低
②缺点:架构非常复杂,运维、监控、部署难度提高
SpringCloud是微服务架构的一站式解决方案,集成了各种优秀微服务功能组件
2.服务拆分和远程调用
任何分布式架构都离不开服务的拆分,微服务也是一样。
2.1.服务拆分原则
这里我总结了微服务拆分时的几个原则:
不同微服务,不要重复开发相同业务
微服务数据独立,不要访问其它微服务的数据库
微服务可以将自己的业务暴露为接口,供其它微服务调用
2.2.服务拆分示例
以课前资料中的微服务cloud-demo为例,其结构如下:
cloud-demo:父工程,管理依赖
- order-service:订单微服务,负责订单相关业务
- user-service:用户微服务,负责用户相关业务
要求:
- 订单微服务和用户微服务都必须有各自的数据库,相互独立
- 订单服务和用户服务都对外暴露Restful的接口
- 订单服务如果需要查询用户信息,只能调用用户服务的Restful接口,不能查询用户数据库
2.2.1.导入Sql语句
首先,将课前资料提供的
cloud-order.sql和cloud-user.sql导入到mysql中:cloud-user表中初始数据如下:
cloud-order表中初始数据如下:
cloud-order表中持有cloud-user表中的id字段。
2.2.2.导入demo工程
用IDEA导入课前资料提供的Demo:
项目结构如下:
导入后,会在IDEA右下角出现弹窗:
点击弹窗,然后按下图选择:
会出现这样的菜单:
配置下项目使用的JDK:
2.3.实现远程调用案例
在order-service服务中,有一个根据id查询订单的接口:
根据id查询订单,返回值是Order对象,如图:
其中的user为null
在user-service中有一个根据id查询用户的接口:
查询的结果如图:
2.3.1.案例需求:
修改order-service中的根据id查询订单业务,要求在查询订单的同时,根据订单中包含的userId查询出用户信息,一起返回。
因此,我们需要在order-service中 向user-service发起一个http的请求,调用http://localhost:8081/user/{userId}这个接口。
大概的步骤是这样的:
- 注册一个RestTemplate的实例到Spring容器
- 修改order-service服务中的OrderService类中的queryOrderById方法,根据Order对象中的userId查询User
- 将查询的User填充到Order对象,一起返回
2.3.2.注册RestTemplate
首先,我们在order-service服务中的OrderApplication启动类中,注册RestTemplate实例:
package cn.itcast.order;

import org.mybatis.spring.annotation.MapperScan;
import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.context.annotation.Bean;
import org.springframework.web.client.RestTemplate;

@MapperScan("cn.itcast.order.mapper")
@SpringBootApplication
public class OrderApplication {

    public static void main(String[] args) {
        SpringApplication.run(OrderApplication.class, args);
    }

    @Bean
    public RestTemplate restTemplate() {
        return new RestTemplate();
    }
}
2.3.3.实现远程调用
修改order-service服务中的cn.itcast.order.service包下的OrderService类中的queryOrderById方法:
2.4.提供者与消费者
在服务调用关系中,会有两个不同的角色:
服务提供者:一次业务中,被其它微服务调用的服务。(提供接口给其它微服务)
服务消费者:一次业务中,调用其它微服务的服务。(调用其它微服务提供的接口)
但是,服务提供者与服务消费者的角色并不是绝对的,而是相对于业务而言。
如果服务A调用了服务B,而服务B又调用了服务C,服务B的角色是什么?
- 对于A调用B的业务而言:A是服务消费者,B是服务提供者
- 对于B调用C的业务而言:B是服务消费者,C是服务提供者
因此,服务B既可以是服务提供者,也可以是服务消费者。
3.Eureka注册中心
假如我们的服务提供者user-service部署了多个实例,如图:
大家思考几个问题:
- order-service在发起远程调用的时候,该如何得知user-service实例的ip地址和端口?
- 有多个user-service实例地址,order-service调用时该如何选择?
- order-service如何得知某个user-service实例是否依然健康,是不是已经宕机?
3.1.Eureka的结构和作用
这些问题都需要利用SpringCloud中的注册中心来解决,其中最广为人知的注册中心就是Eureka,其结构如下:
回答之前的各个问题。
问题1:order-service如何得知user-service实例地址?
获取地址信息的流程如下:
- user-service服务实例启动后,将自己的信息注册到eureka-server(Eureka服务端)。这个叫服务注册
- eureka-server保存服务名称到服务实例地址列表的映射关系
- order-service根据服务名称,拉取实例地址列表。这个叫服务发现或服务拉取
问题2:order-service如何从多个user-service实例中选择具体的实例?
- order-service从实例列表中利用负载均衡算法选中一个实例地址
- 向该实例地址发起远程调用
问题3:order-service如何得知某个user-service实例是否依然健康,是不是已经宕机?
- user-service会每隔一段时间(默认30秒)向eureka-server发起请求,报告自己状态,称为心跳
- 当超过一定时间没有发送心跳时,eureka-server会认为微服务实例故障,将该实例从服务列表中剔除
- order-service拉取服务时,就能将故障实例排除了
注意:一个微服务,既可以是服务提供者,又可以是服务消费者,因此eureka将服务注册、服务发现等功能统一封装到了eureka-client端
因此,接下来我们动手实践的步骤包括:
3.2.搭建eureka-server
首先大家注册中心服务端:eureka-server,这必须是一个独立的微服务
3.2.1.创建eureka-server服务
在cloud-demo父工程下,创建一个子模块:
填写模块信息:
然后填写服务信息:
3.2.2.引入eureka依赖
引入SpringCloud为eureka提供的starter依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId>
</dependency>
3.2.3.编写启动类
给eureka-server服务编写一个启动类,一定要添加一个@EnableEurekaServer注解,开启eureka的注册中心功能:
package cn.itcast.eureka;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.cloud.netflix.eureka.server.EnableEurekaServer;

@SpringBootApplication
@EnableEurekaServer
public class EurekaApplication {
    public static void main(String[] args) {
        SpringApplication.run(EurekaApplication.class, args);
    }
}
3.2.4.编写配置文件
编写一个application.yml文件,内容如下:
server:
  port: 10086
spring:
  application:
    name: eureka-server
eureka:
  client:
    service-url:
      defaultZone: http://127.0.0.1:10086/eureka
3.2.5.启动服务
启动微服务,然后在浏览器访问:http://127.0.0.1:10086
看到下面结果应该是成功了:
3.3.服务注册
下面,我们将user-service注册到eureka-server中去。
1)引入依赖
在user-service的pom文件中,引入下面的eureka-client依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId>
</dependency>
2)配置文件
在user-service中,修改application.yml文件,添加服务名称、eureka地址:
spring:
  application:
    name: userservice
eureka:
  client:
    service-url:
      defaultZone: http://127.0.0.1:10086/eureka
3)启动多个user-service实例
为了演示一个服务有多个实例的场景,我们添加一个SpringBoot的启动配置,再启动一个user-service。
首先,复制原来的user-service启动配置:
然后,在弹出的窗口中,填写信息:
现在,SpringBoot窗口会出现两个user-service启动配置:
不过,第一个是8081端口,第二个是8082端口。
启动两个user-service实例:
查看eureka-server管理页面:
3.4.服务发现
下面,我们将order-service的逻辑修改:向eureka-server拉取user-service的信息,实现服务发现。
1)引入依赖
之前说过,服务发现、服务注册统一都封装在eureka-client依赖,因此这一步与服务注册时一致。
在order-service的pom文件中,引入下面的eureka-client依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-netflix-eureka-client</artifactId>
</dependency>
2)配置文件
服务发现也需要知道eureka地址,因此第二步与服务注册一致,都是配置eureka信息:
在order-service中,修改application.yml文件,添加服务名称、eureka地址:
spring:
  application:
    name: orderservice
eureka:
  client:
    service-url:
      defaultZone: http://127.0.0.1:10086/eureka
3)服务拉取和负载均衡
最后,我们要去eureka-server中拉取user-service服务的实例列表,并且实现负载均衡。
不过这些动作不用我们去做,只需要添加一些注解即可。
在order-service的OrderApplication中,给RestTemplate这个Bean添加一个@LoadBalanced注解:
修改order-service服务中的cn.itcast.order.service包下的OrderService类中的queryOrderById方法。修改访问的url路径,用服务名代替ip、端口:
spring会自动帮助我们从eureka-server端,根据userservice这个服务名称,获取实例列表,而后完成负载均衡。
4.Ribbon负载均衡
上一节中,我们添加了@LoadBalanced注解,即可实现负载均衡功能,这是什么原理呢?
4.1.负载均衡原理
SpringCloud底层其实是利用了一个名为Ribbon的组件,来实现负载均衡功能的。
那么我们发出的请求明明是http://userservice/user/1,怎么变成了http://localhost:8081的呢?
4.2.源码跟踪
为什么我们只输入了service名称就可以访问了呢?之前还要获取ip和端口。
显然有人帮我们根据service名称,获取到了服务实例的ip和端口。它就是
LoadBalancerInterceptor,这个类会在对RestTemplate的请求进行拦截,然后从Eureka根据服务id获取服务列表,随后利用负载均衡算法得到真实的服务地址信息,替换服务id。我们进行源码跟踪:
1)LoadBalancerIntercepor
可以看到这里的intercept方法,拦截了用户的HttpRequest请求,然后做了几件事:
request.getURI():获取请求uri,本例中就是 http://user-service/user/8originalUri.getHost():获取uri路径的主机名,其实就是服务id,user-servicethis.loadBalancer.execute():处理服务id,和用户请求。这里的
this.loadBalancer是LoadBalancerClient类型,我们继续跟入。2)LoadBalancerClient
继续跟入execute方法:
代码是这样的:
- getLoadBalancer(serviceId):根据服务id获取ILoadBalancer,而ILoadBalancer会拿着服务id去eureka中获取服务列表并保存起来。
- getServer(loadBalancer):利用内置的负载均衡算法,从服务列表中选择一个。本例中,可以看到获取了8082端口的服务
放行后,再次访问并跟踪,发现获取的是8081:
果然实现了负载均衡。
3)负载均衡策略IRule
在刚才的代码中,可以看到获取服务使通过一个
getServer方法来做负载均衡:我们继续跟入:
继续跟踪源码chooseServer方法,发现这么一段代码:
我们看看这个rule是谁:
这里的rule默认值是一个
RoundRobinRule,看类的介绍:这不就是轮询的意思嘛。
到这里,整个负载均衡的流程我们就清楚了。
4)总结
SpringCloudRibbon的底层采用了一个拦截器,拦截了RestTemplate发出的请求,对地址做了修改。用一幅图来总结一下:
基本流程如下:
- 拦截我们的RestTemplate请求http://userservice/user/1
- RibbonLoadBalancerClient会从请求url中获取服务名称,也就是user-service
- DynamicServerListLoadBalancer根据user-service到eureka拉取服务列表
- eureka返回列表,localhost:8081、localhost:8082
- IRule利用内置负载均衡规则,从列表中选择一个,例如localhost:8081
- RibbonLoadBalancerClient修改请求地址,用localhost:8081替代userservice,得到http://localhost:8081/user/1,发起真实请求
4.3.负载均衡策略
4.3.1.负载均衡策略
负载均衡的规则都定义在IRule接口中,而IRule有很多不同的实现类:
不同规则的含义如下:
内置负载均衡规则类 规则描述 RoundRobinRule 简单轮询服务列表来选择服务器。它是Ribbon默认的负载均衡规则。 AvailabilityFilteringRule 对以下两种服务器进行忽略: (1)在默认情况下,这台服务器如果3次连接失败,这台服务器就会被设置为“短路”状态。短路状态将持续30秒,如果再次连接失败,短路的持续时间就会几何级地增加。 (2)并发数过高的服务器。如果一个服务器的并发连接数过高,配置了AvailabilityFilteringRule规则的客户端也会将其忽略。并发连接数的上限,可以由客户端的<clientName>.<clientConfigNameSpace>.ActiveConnectionsLimit属性进行配置。 WeightedResponseTimeRule 为每一个服务器赋予一个权重值。服务器响应时间越长,这个服务器的权重就越小。这个规则会随机选择服务器,这个权重值会影响服务器的选择。 ZoneAvoidanceRule 以区域可用的服务器为基础进行服务器的选择。使用Zone对服务器进行分类,这个Zone可以理解为一个机房、一个机架等。而后再对Zone内的多个服务做轮询。 BestAvailableRule 忽略那些短路的服务器,并选择并发数较低的服务器。 RandomRule 随机选择一个可用的服务器。 RetryRule 重试机制的选择逻辑 默认的实现就是ZoneAvoidanceRule,是一种轮询方案
4.3.2.自定义负载均衡策略
通过定义IRule实现可以修改负载均衡规则,有两种方式:
- 代码方式:在order-service中的OrderApplication类中,定义一个新的IRule:
@Bean
public IRule randomRule(){
    return new RandomRule();
}
- 配置文件方式:在order-service的application.yml文件中,添加新的配置也可以修改规则:
userservice: # 给某个微服务配置负载均衡规则,这里是userservice服务 ribbon: NFLoadBalancerRuleClassName: com.netflix.loadbalancer.RandomRule # 负载均衡规则注意,一般用默认的负载均衡规则,不做修改。
4.4.饥饿加载
Ribbon默认是采用懒加载,即第一次访问时才会去创建LoadBalanceClient,请求时间会很长。
而饥饿加载则会在项目启动时创建,降低第一次访问的耗时,通过下面配置开启饥饿加载:
ribbon:
  eager-load:
    enabled: true
    clients: userservice
5.Nacos注册中心
国内公司一般都推崇阿里巴巴的技术,比如注册中心,SpringCloudAlibaba也推出了一个名为Nacos的注册中心。
5.1.认识和安装Nacos
Nacos是阿里巴巴的产品,现在是SpringCloud中的一个组件。相比Eureka功能更加丰富,在国内受欢迎程度较高。
安装方式可以参考课前资料《Nacos安装指南.md》
5.2.服务注册到nacos
Nacos是SpringCloudAlibaba的组件,而SpringCloudAlibaba也遵循SpringCloud中定义的服务注册、服务发现规范。因此使用Nacos和使用Eureka对于微服务来说,并没有太大区别。
主要差异在于:
- 依赖不同
- 服务地址不同
1)引入依赖
在cloud-demo父工程的pom文件中的
<dependencyManagement>中引入SpringCloudAlibaba的依赖:<dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-alibaba-dependencies</artifactId> <version>2.2.6.RELEASE</version> <type>pom</type> <scope>import</scope> </dependency>然后在user-service和order-service中的pom文件中引入nacos-discovery依赖:
<dependency> <groupId>com.alibaba.cloud</groupId> <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId> </dependency>注意:不要忘了注释掉eureka的依赖。
2)配置nacos地址
在user-service和order-service的application.yml中添加nacos地址:
spring: cloud: nacos: server-addr: localhost:8848注意:不要忘了注释掉eureka的地址
3)重启
重启微服务后,登录nacos管理页面,可以看到微服务信息:
5.3.服务分级存储模型
一个服务可以有多个实例,例如我们的user-service,可以有:
- 127.0.0.1:8081
- 127.0.0.1:8082
- 127.0.0.1:8083
假如这些实例分布于全国各地的不同机房,例如:
- 127.0.0.1:8081,在上海机房
- 127.0.0.1:8082,在上海机房
- 127.0.0.1:8083,在杭州机房
Nacos就将同一机房内的实例 划分为一个集群。
也就是说,user-service是服务,一个服务可以包含多个集群,如杭州、上海,每个集群下可以有多个实例,形成分级模型,如图:
微服务互相访问时,应该尽可能访问同集群实例,因为本地访问速度更快。当本集群内不可用时,才访问其它集群。例如:
杭州机房内的order-service应该优先访问同机房的user-service。
5.3.1.给user-service配置集群
修改user-service的application.yml文件,添加集群配置:
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
        cluster-name: HZ # 集群名称
重启两个user-service实例后,我们可以在nacos控制台看到下面结果:
我们再次复制一个user-service启动配置,添加属性:
-Dserver.port=8083 -Dspring.cloud.nacos.discovery.cluster-name=SH配置如图所示:
启动UserApplication3后再次查看nacos控制台:
5.3.2.同集群优先的负载均衡
默认的
ZoneAvoidanceRule并不能实现根据同集群优先来实现负载均衡。因此Nacos中提供了一个
NacosRule的实现,可以优先从同集群中挑选实例。1)给order-service配置集群信息
修改order-service的application.yml文件,添加集群配置:
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
        cluster-name: HZ # 集群名称
2)修改负载均衡规则
修改order-service的application.yml文件,修改负载均衡规则:
userservice:
  ribbon:
    NFLoadBalancerRuleClassName: com.alibaba.cloud.nacos.ribbon.NacosRule # 负载均衡规则
5.4.权重配置
实际部署中会出现这样的场景:
服务器设备性能有差异,部分实例所在机器性能较好,另一些较差,我们希望性能好的机器承担更多的用户请求。
但默认情况下NacosRule是同集群内随机挑选,不会考虑机器的性能问题。
因此,Nacos提供了权重配置来控制访问频率,权重越大则访问频率越高。
在nacos控制台,找到user-service的实例列表,点击编辑,即可修改权重:
在弹出的编辑窗口,修改权重:
注意:如果权重修改为0,则该实例永远不会被访问
5.5.环境隔离
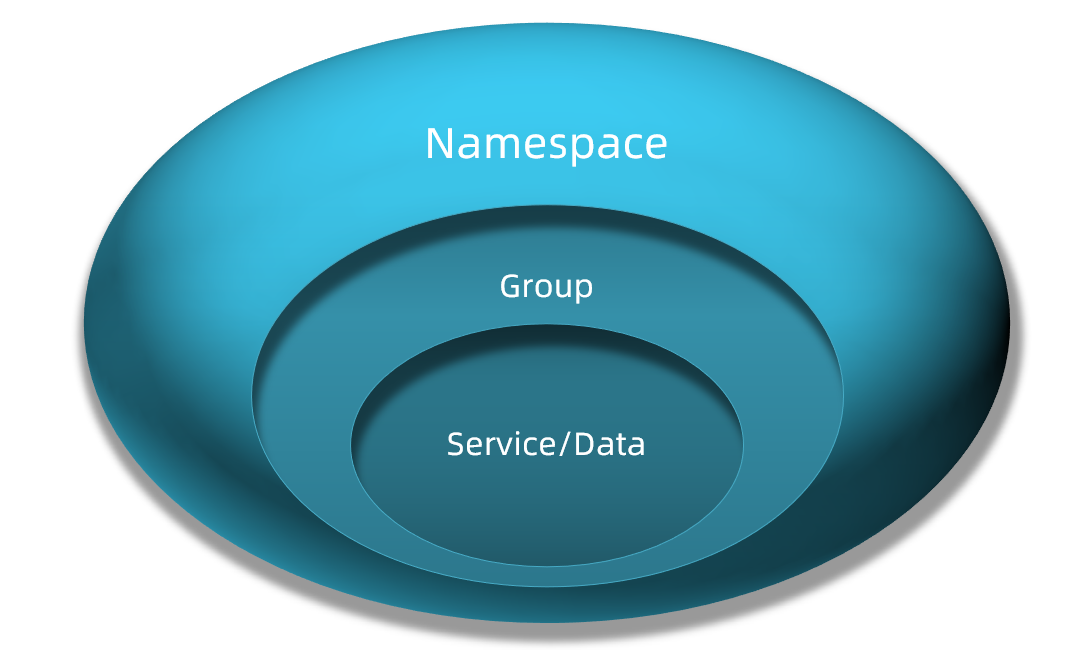
Nacos提供了namespace来实现环境隔离功能。
nacos中可以有多个namespace
namespace下可以有group、service等
不同namespace之间相互隔离,例如不同namespace的服务互相不可见
5.5.1.创建namespace
默认情况下,所有service、data、group都在同一个namespace,名为public:
我们可以点击页面新增按钮,添加一个namespace:
然后,填写表单:
就能在页面看到一个新的namespace:
5.5.2.给微服务配置namespace
给微服务配置namespace只能通过修改配置来实现。
例如,修改order-service的application.yml文件:
spring:
  cloud:
    nacos:
      server-addr: localhost:8848
      discovery:
        cluster-name: HZ
        namespace: 492a7d5d-237b-46a1-a99a-fa8e98e4b0f9 # 命名空间,填ID
重启order-service后,访问控制台,可以看到下面的结果:
此时访问order-service,因为namespace不同,会导致找不到userservice,控制台会报错:
5.6.Nacos与Eureka的区别
Nacos的服务实例分为两种l类型:
- 临时实例:如果实例宕机超过一定时间,会从服务列表剔除,默认的类型。
- 非临时实例:如果实例宕机,不会从服务列表剔除,也可以叫永久实例。
配置一个服务实例为永久实例:
spring:
  cloud:
    nacos:
      discovery:
        ephemeral: false # 设置为非临时实例
Nacos和Eureka整体结构类似,服务注册、服务拉取、心跳等待,但是也存在一些差异:
Nacos与eureka的共同点
- 都支持服务注册和服务拉取
- 都支持服务提供者心跳方式做健康检测
Nacos与Eureka的区别
- Nacos支持服务端主动检测提供者状态:临时实例采用心跳模式,非临时实例采用主动检测模式
- 临时实例心跳不正常会被剔除,非临时实例则不会被剔除
- Nacos支持服务列表变更的消息推送模式,服务列表更新更及时
- Nacos集群默认采用AP方式,当集群中存在非临时实例时,采用CP模式;Eureka采用AP方式


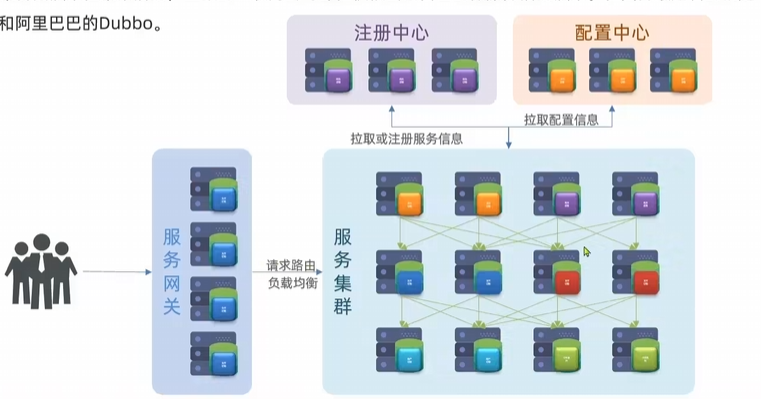
微服务结构
Nacos结构
Nacos与Eureka的区别
- Nacos支持服务端主动检测提供者状态:临时实例采用心跳模式,非临时实例采用主动检测模式
- 临时实例心跳不正常会被剔除,非临时实例则不会被剔除
- Nacos支持服务列表变更的消息推送模式,服务列表更新更及时
- Nacos集群默认采用AP方式,当集群中存在非临时实例时,采用CP模式;Eureka采用AP方式
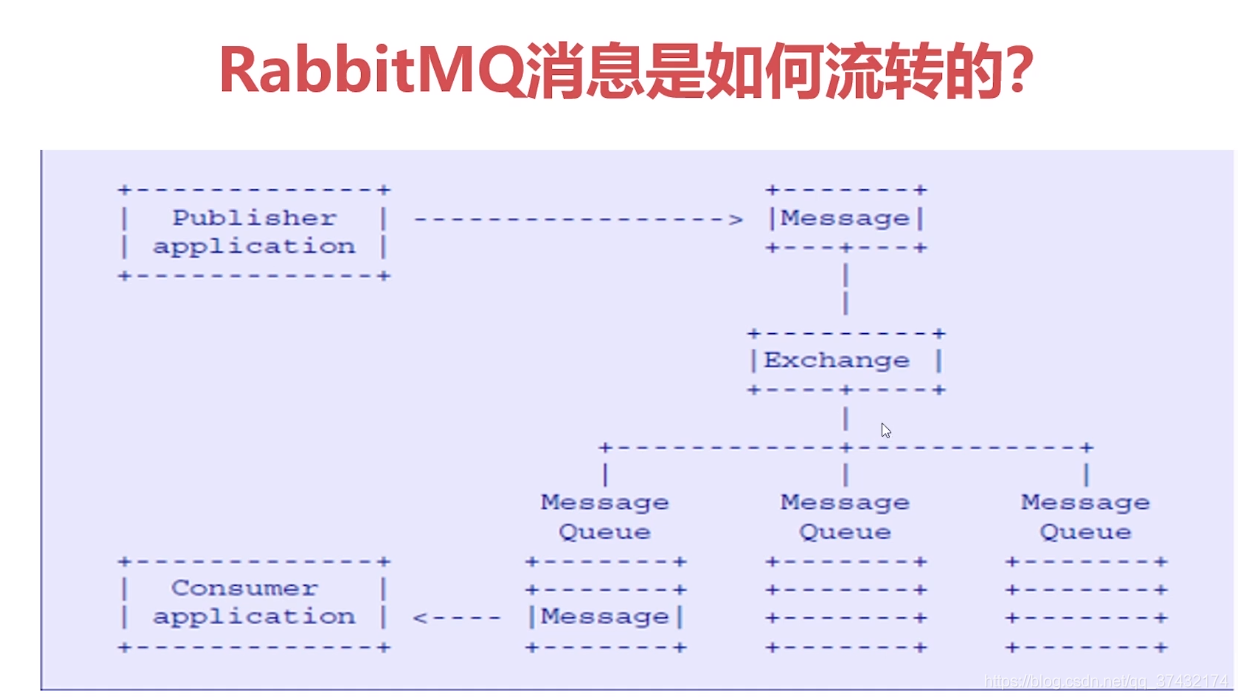
rabbitmq结构
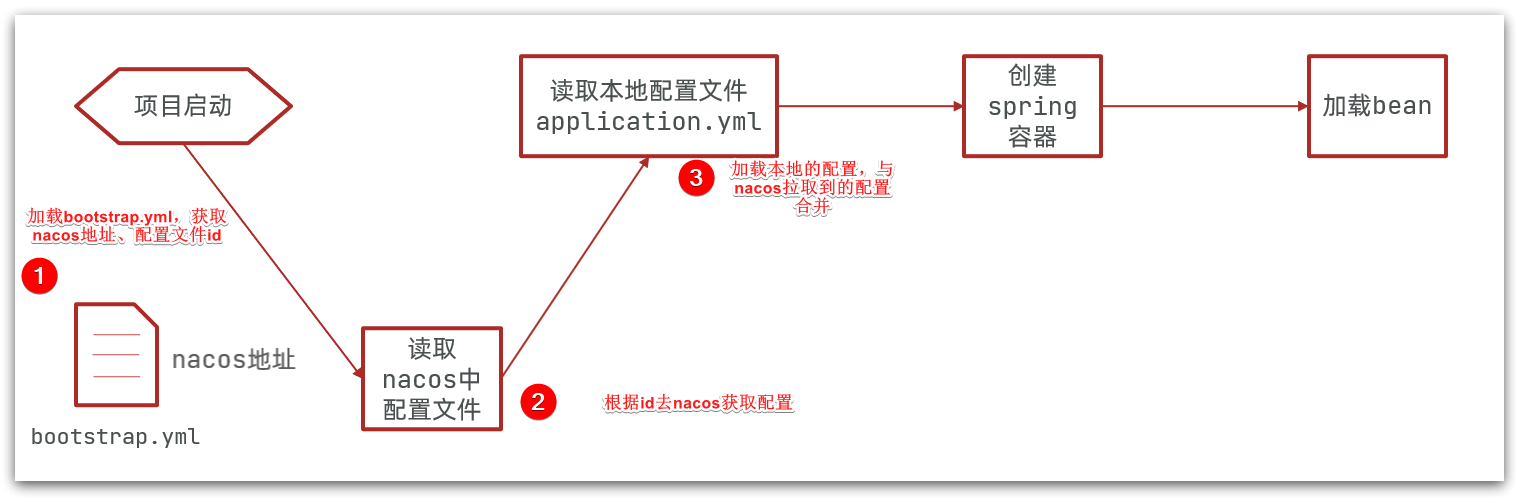
bootstrap.yaml文件
解决的问题:微服务要拉取nacos中管理的配置,并且与本地的application.yml配置合并,才能完成项目启动,但如果尚未读取application.yml,又如何得知nacos地址呢?
spring引入了一种新的配置文件:bootstrap.yaml文件,会在application.yml之前被读取,流程如下:
读取nacos热更新配置的bootstrap.yaml文件写法
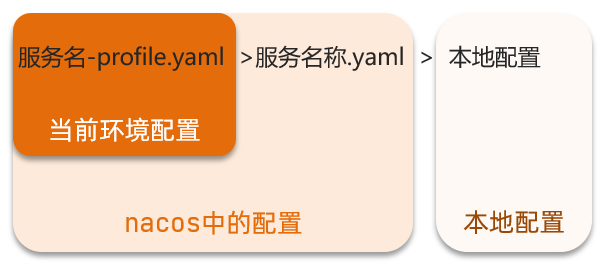
当nacos、服务本地同时出现相同属性时,优先级有高低之分:
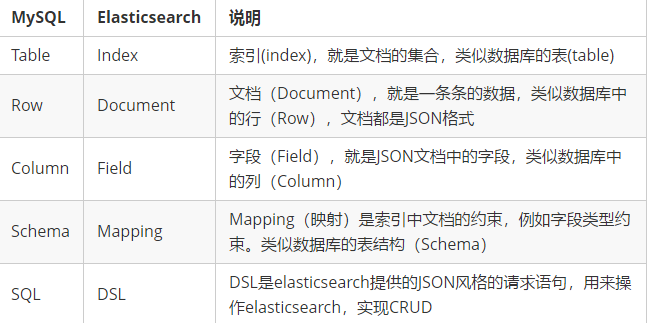
mysql与elasticsearch的概念对比:
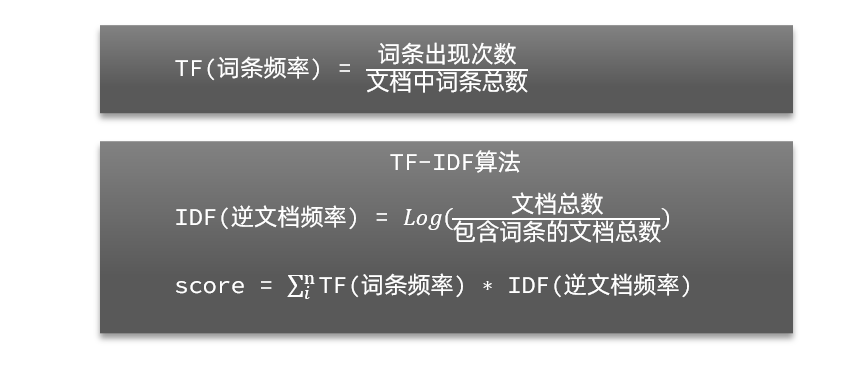
在elasticsearch中,早期使用的打分算法是TF-IDF算法,公式如下:
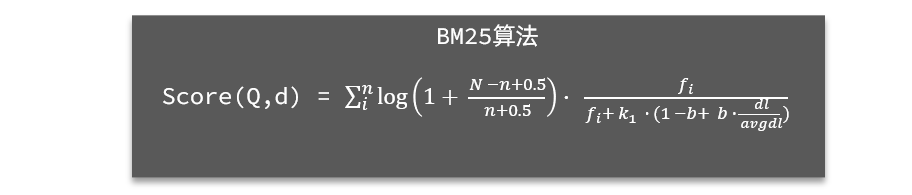
在后来的5.1版本升级中,elasticsearch将算法改进为BM25算法,公式如下:
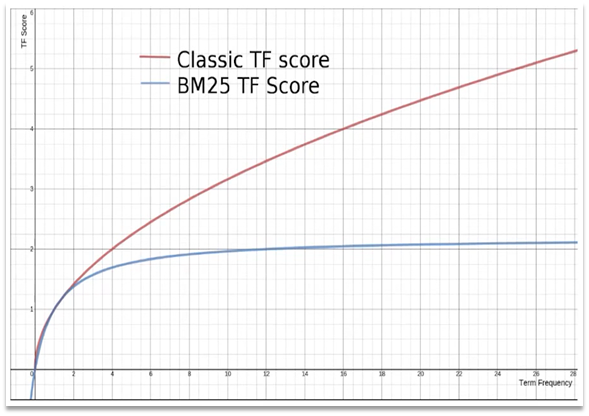
TF-IDF算法有一个缺陷,就是词条频率越高,文档得分也会越高,单个词条对文档影响较大。而BM25则会让单个词条的算分有一个上限,曲线更加平滑:
1.Nacos配置管理
Nacos除了可以做注册中心,同样可以做配置管理来使用。
1.1.统一配置管理
当微服务部署的实例越来越多,达到数十、数百时,逐个修改微服务配置就会让人抓狂,而且很容易出错。我们需要一种统一配置管理方案,可以集中管理所有实例的配置。
Nacos一方面可以将配置集中管理,另一方可以在配置变更时,及时通知微服务,实现配置的热更新。
1.1.1.在nacos中添加配置文件
如何在nacos中管理配置呢?
然后在弹出的表单中,填写配置信息:
注意:项目的核心配置,需要热更新的配置才有放到nacos管理的必要。基本不会变更的一些配置还是保存在微服务本地比较好。
1.1.2.从微服务拉取配置
微服务要拉取nacos中管理的配置,并且与本地的application.yml配置合并,才能完成项目启动。
但如果尚未读取application.yml,又如何得知nacos地址呢?
因此spring引入了一种新的配置文件:bootstrap.yaml文件,会在application.yml之前被读取,流程如下:
1)引入nacos-config依赖
首先,在user-service服务中,引入nacos-config的客户端依赖:
<!--nacos配置管理依赖-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-config</artifactId>
</dependency>
2)添加bootstrap.yaml
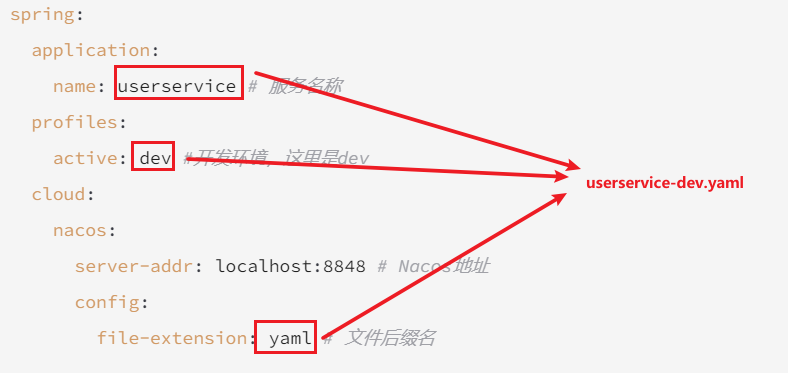
然后,在user-service中添加一个bootstrap.yaml文件,内容如下:
spring:
  application:
    name: userservice # 服务名称
  profiles:
    active: dev #开发环境,这里是dev
  cloud:
    nacos:
      server-addr: localhost:8848 # Nacos地址
      config:
        file-extension: yaml # 文件后缀名
这里会根据spring.cloud.nacos.server-addr获取nacos地址,再根据
${spring.application.name}-${spring.profiles.active}.${spring.cloud.nacos.config.file-extension}作为文件id,来读取配置。本例中,就是去读取
userservice-dev.yaml:
3)读取nacos配置
在user-service中的UserController中添加业务逻辑,读取pattern.dateformat配置:
完整代码:
package cn.itcast.user.web;

import cn.itcast.user.pojo.User;
import cn.itcast.user.service.UserService;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.web.bind.annotation.*;

import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;

@Slf4j
@RestController
@RequestMapping("/user")
public class UserController {

    @Autowired
    private UserService userService;

    @Value("${pattern.dateformat}")
    private String dateformat;

    @GetMapping("now")
    public String now(){
        return LocalDateTime.now().format(DateTimeFormatter.ofPattern(dateformat));
    }
    // ...略
}
在页面访问,可以看到效果:
1.2.配置热更新
我们最终的目的,是修改nacos中的配置后,微服务中无需重启即可让配置生效,也就是配置热更新。
要实现配置热更新,可以使用两种方式:
1.2.1.方式一
在@Value注入的变量所在类上添加注解@RefreshScope:
1.2.2.方式二
使用@ConfigurationProperties注解代替@Value注解。
在user-service服务中,添加一个类,读取patterrn.dateformat属性:
package cn.itcast.user.config;

import lombok.Data;
import org.springframework.boot.context.properties.ConfigurationProperties;
import org.springframework.stereotype.Component;

@Component
@Data
@ConfigurationProperties(prefix = "pattern")
public class PatternProperties {
    private String dateformat;
}
在UserController中使用这个类代替@Value:
完整代码:
package cn.itcast.user.web;

import cn.itcast.user.config.PatternProperties;
import cn.itcast.user.pojo.User;
import cn.itcast.user.service.UserService;
import lombok.extern.slf4j.Slf4j;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PathVariable;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;

@Slf4j
@RestController
@RequestMapping("/user")
public class UserController {

    @Autowired
    private UserService userService;

    @Autowired
    private PatternProperties patternProperties;

    @GetMapping("now")
    public String now(){
        return LocalDateTime.now().format(DateTimeFormatter.ofPattern(patternProperties.getDateformat()));
    }

    // 略
}
1.3.配置共享
其实微服务启动时,会去nacos读取多个配置文件,例如:
[spring.application.name]-[spring.profiles.active].yaml,例如:userservice-dev.yaml[spring.application.name].yaml,例如:userservice.yaml而
[spring.application.name].yaml不包含环境,因此可以被多个环境共享。下面我们通过案例来测试配置共享
1)添加一个环境共享配置
我们在nacos中添加一个userservice.yaml文件:
2)在user-service中读取共享配置
在user-service服务中,修改PatternProperties类,读取新添加的属性:
在user-service服务中,修改UserController,添加一个方法:
3)运行两个UserApplication,使用不同的profile
修改UserApplication2这个启动项,改变其profile值:
这样,UserApplication(8081)使用的profile是dev,UserApplication2(8082)使用的profile是test。
启动UserApplication和UserApplication2
访问http://localhost:8081/user/prop,结果:
访问http://localhost:8082/user/prop,结果:
可以看出来,不管是dev,还是test环境,都读取到了envSharedValue这个属性的值。
4)配置共享的优先级
当nacos、服务本地同时出现相同属性时,优先级有高低之分:
1.4.搭建Nacos集群
Nacos生产环境下一定要部署为集群状态,部署方式参考课前资料中的文档:
2.Feign远程调用
先来看我们以前利用RestTemplate发起远程调用的代码:
存在下面的问题:
•代码可读性差,编程体验不统一
•参数复杂URL难以维护
Feign是一个声明式的http客户端,官方地址:https://github.com/OpenFeign/feign
其作用就是帮助我们优雅的实现http请求的发送,解决上面提到的问题。
2.1.Feign替代RestTemplate
Fegin的使用步骤如下:
1)引入依赖
我们在order-service服务的pom文件中引入feign的依赖:
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
2)添加注解
在order-service的启动类添加注解开启Feign的功能:
3)编写Feign的客户端
在order-service中新建一个接口,内容如下:
package cn.itcast.order.client;

import cn.itcast.order.pojo.User;
import org.springframework.cloud.openfeign.FeignClient;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PathVariable;

@FeignClient("userservice")
public interface UserClient {
    @GetMapping("/user/{id}")
    User findById(@PathVariable("id") Long id);
}
这个客户端主要是基于SpringMVC的注解来声明远程调用的信息,比如:
- 服务名称:userservice
- 请求方式:GET
- 请求路径:/user/{id}
- 请求参数:Long id
- 返回值类型:User
这样,Feign就可以帮助我们发送http请求,无需自己使用RestTemplate来发送了。
4)测试
修改order-service中的OrderService类中的queryOrderById方法,使用Feign客户端代替RestTemplate:
是不是看起来优雅多了。
5)总结
使用Feign的步骤:
① 引入依赖
② 添加@EnableFeignClients注解
③ 编写FeignClient接口
④ 使用FeignClient中定义的方法代替RestTemplate
2.2.自定义配置
Feign可以支持很多的自定义配置,如下表所示:
类型 作用 说明 feign.Logger.Level 修改日志级别 包含四种不同的级别:NONE、BASIC、HEADERS、FULL feign.codec.Decoder 响应结果的解析器 http远程调用的结果做解析,例如解析json字符串为java对象 feign.codec.Encoder 请求参数编码 将请求参数编码,便于通过http请求发送 feign. Contract 支持的注解格式 默认是SpringMVC的注解 feign. Retryer 失败重试机制 请求失败的重试机制,默认是没有,不过会使用Ribbon的重试 一般情况下,默认值就能满足我们使用,如果要自定义时,只需要创建自定义的@Bean覆盖默认Bean即可。
下面以日志为例来演示如何自定义配置。
2.2.1.配置文件方式
基于配置文件修改feign的日志级别可以针对单个服务:
feign:
  client:
    config:
      userservice: # 针对某个微服务的配置
        loggerLevel: FULL #  日志级别
也可以针对所有服务:
feign:
  client:
    config:
      default: # 这里用default就是全局配置,如果是写服务名称,则是针对某个微服务的配置
        loggerLevel: FULL #  日志级别
而日志的级别分为四种:
- NONE:不记录任何日志信息,这是默认值。
- BASIC:仅记录请求的方法,URL以及响应状态码和执行时间
- HEADERS:在BASIC的基础上,额外记录了请求和响应的头信息
- FULL:记录所有请求和响应的明细,包括头信息、请求体、元数据。
2.2.2.Java代码方式
也可以基于Java代码来修改日志级别,先声明一个类,然后声明一个Logger.Level的对象:
public class DefaultFeignConfiguration { @Bean public Logger.Level feignLogLevel(){ return Logger.Level.BASIC; // 日志级别为BASIC } }如果要全局生效,将其放到启动类的@EnableFeignClients这个注解中:
@EnableFeignClients(defaultConfiguration = DefaultFeignConfiguration .class)如果是局部生效,则把它放到对应的@FeignClient这个注解中:
@FeignClient(value = "userservice", configuration = DefaultFeignConfiguration .class)2.3.Feign使用优化
Feign底层发起http请求,依赖于其它的框架。其底层客户端实现包括:
•URLConnection:默认实现,不支持连接池
•Apache HttpClient :支持连接池
•OKHttp:支持连接池
因此提高Feign的性能主要手段就是使用连接池代替默认的URLConnection。
这里我们用Apache的HttpClient来演示。
1)引入依赖
在order-service的pom文件中引入Apache的HttpClient依赖:
<!--httpClient的依赖 -->
<dependency>
    <groupId>io.github.openfeign</groupId>
    <artifactId>feign-httpclient</artifactId>
</dependency>
2)配置连接池
在order-service的application.yml中添加配置:
feign:
  client:
    config:
      default: # default全局的配置
        loggerLevel: BASIC # 日志级别,BASIC就是基本的请求和响应信息
  httpclient:
    enabled: true # 开启feign对HttpClient的支持
    max-connections: 200 # 最大的连接数
    max-connections-per-route: 50 # 每个路径的最大连接数
接下来,在FeignClientFactoryBean中的loadBalance方法中打断点:
Debug方式启动order-service服务,可以看到这里的client,底层就是Apache HttpClient:
总结,Feign的优化:
1.日志级别尽量用basic
2.使用HttpClient或OKHttp代替URLConnection
① 引入feign-httpClient依赖
② 配置文件开启httpClient功能,设置连接池参数
2.4.最佳实践
所谓最近实践,就是使用过程中总结的经验,最好的一种使用方式。
自习观察可以发现,Feign的客户端与服务提供者的controller代码非常相似:
feign客户端:
UserController:
有没有一种办法简化这种重复的代码编写呢?
2.4.1.继承方式
一样的代码可以通过继承来共享:
1)定义一个API接口,利用定义方法,并基于SpringMVC注解做声明。
2)Feign客户端和Controller都集成改接口
优点:
- 简单
- 实现了代码共享
缺点:
- 服务提供方、服务消费方紧耦合
- 参数列表中的注解映射并不会继承,因此Controller中必须再次声明方法、参数列表、注解
2.4.2.抽取方式
将Feign的Client抽取为独立模块,并且把接口有关的POJO、默认的Feign配置都放到这个模块中,提供给所有消费者使用。
例如,将UserClient、User、Feign的默认配置都抽取到一个feign-api包中,所有微服务引用该依赖包,即可直接使用。
2.4.3.实现基于抽取的最佳实践
1)抽取
首先创建一个module,命名为feign-api:
项目结构:
在feign-api中然后引入feign的starter依赖
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-openfeign</artifactId>
</dependency>
然后,order-service中编写的UserClient、User、DefaultFeignConfiguration都复制到feign-api项目中
2)在order-service中使用feign-api
首先,删除order-service中的UserClient、User、DefaultFeignConfiguration等类或接口。
在order-service的pom文件中中引入feign-api的依赖:
<dependency>
    <groupId>cn.itcast.demo</groupId>
    <artifactId>feign-api</artifactId>
    <version>1.0</version>
</dependency>
修改order-service中的所有与上述三个组件有关的导包部分,改成导入feign-api中的包
3)重启测试
重启后,发现服务报错了:
这是因为UserClient现在在cn.itcast.feign.clients包下,
而order-service的@EnableFeignClients注解是在cn.itcast.order包下,不在同一个包,无法扫描到UserClient。
4)解决扫描包问题
方式一:
指定Feign应该扫描的包:
@EnableFeignClients(basePackages = "cn.itcast.feign.clients")方式二:
指定需要加载的Client接口:
@EnableFeignClients(clients = {UserClient.class})3.Gateway服务网关
Spring Cloud Gateway 是 Spring Cloud 的一个全新项目,该项目是基于 Spring 5.0,Spring Boot 2.0 和 Project Reactor 等响应式编程和事件流技术开发的网关,它旨在为微服务架构提供一种简单有效的统一的 API 路由管理方式。
3.1.为什么需要网关
Gateway网关是我们服务的守门神,所有微服务的统一入口。
网关的核心功能特性:
- 请求路由
- 权限控制
- 限流
架构图:
权限控制:网关作为微服务入口,需要校验用户是是否有请求资格,如果没有则进行拦截。
路由和负载均衡:一切请求都必须先经过gateway,但网关不处理业务,而是根据某种规则,把请求转发到某个微服务,这个过程叫做路由。当然路由的目标服务有多个时,还需要做负载均衡。
限流:当请求流量过高时,在网关中按照下流的微服务能够接受的速度来放行请求,避免服务压力过大。
在SpringCloud中网关的实现包括两种:
- gateway
- zuul
Zuul是基于Servlet的实现,属于阻塞式编程。而SpringCloudGateway则是基于Spring5中提供的WebFlux,属于响应式编程的实现,具备更好的性能。
3.2.gateway快速入门
下面,我们就演示下网关的基本路由功能。基本步骤如下:
- 创建SpringBoot工程gateway,引入网关依赖
- 编写启动类
- 编写基础配置和路由规则
- 启动网关服务进行测试
1)创建gateway服务,引入依赖
创建服务:
引入依赖:
<!--网关-->
<dependency>
    <groupId>org.springframework.cloud</groupId>
    <artifactId>spring-cloud-starter-gateway</artifactId>
</dependency>
<!--nacos服务发现依赖-->
<dependency>
    <groupId>com.alibaba.cloud</groupId>
    <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
</dependency>
2)编写启动类
package cn.itcast.gateway;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
public class GatewayApplication {

	public static void main(String[] args) {
		SpringApplication.run(GatewayApplication.class, args);
	}
}
3)编写基础配置和路由规则
创建application.yml文件,内容如下:
server:
  port: 10010 # 网关端口
spring:
  application:
    name: gateway # 服务名称
  cloud:
    nacos:
      server-addr: localhost:8848 # nacos地址
    gateway:
      routes: # 网关路由配置
        - id: user-service # 路由id,自定义,只要唯一即可
          # uri: http://127.0.0.1:8081 # 路由的目标地址 http就是固定地址
          uri: lb://userservice # 路由的目标地址 lb就是负载均衡,后面跟服务名称
          predicates: # 路由断言,也就是判断请求是否符合路由规则的条件
            - Path=/user/** # 这个是按照路径匹配,只要以/user/开头就符合要求
我们将符合
Path规则的一切请求,都代理到uri参数指定的地址。本例中,我们将
/user/**开头的请求,代理到lb://userservice,lb是负载均衡,根据服务名拉取服务列表,实现负载均衡。4)重启测试
重启网关,访问http://localhost:10010/user/1时,符合
/user/**规则,请求转发到uri:http://userservice/user/1,得到了结果:5)网关路由的流程图
整个访问的流程如下:
总结:
网关搭建步骤:
- 创建项目,引入nacos服务发现和gateway依赖
- 配置application.yml,包括服务基本信息、nacos地址、路由
路由配置包括:
- 路由id:路由的唯一标示
- 路由目标(uri):路由的目标地址,http代表固定地址,lb代表根据服务名负载均衡
- 路由断言(predicates):判断路由的规则,
- 路由过滤器(filters):对请求或响应做处理
接下来,就重点来学习路由断言和路由过滤器的详细知识
3.3.断言工厂
我们在配置文件中写的断言规则只是字符串,这些字符串会被Predicate Factory读取并处理,转变为路由判断的条件
例如Path=/user/**是按照路径匹配,这个规则是由
org.springframework.cloud.gateway.handler.predicate.PathRoutePredicateFactory类来处理的,像这样的断言工厂在SpringCloudGateway还有十几个:
名称 说明 示例 After 是某个时间点后的请求 - After=2037-01-20T17:42:47.789-07:00[America/Denver] Before 是某个时间点之前的请求 - Before=2031-04-13T15:14:47.433+08:00[Asia/Shanghai] Between 是某两个时间点之前的请求 - Between=2037-01-20T17:42:47.789-07:00[America/Denver], 2037-01-21T17:42:47.789-07:00[America/Denver] Cookie 请求必须包含某些cookie - Cookie=chocolate, ch.p Header 请求必须包含某些header - Header=X-Request-Id, \d+ Host 请求必须是访问某个host(域名) - Host= .somehost.org, .anotherhost.org Method 请求方式必须是指定方式 - Method=GET,POST Path 请求路径必须符合指定规则 - Path=/red/{segment},/blue/** Query 请求参数必须包含指定参数 - Query=name, Jack或者- Query=name RemoteAddr 请求者的ip必须是指定范围 - RemoteAddr=192.168.1.1/24 Weight 权重处理 我们只需要掌握Path这种路由工程就可以了。
3.4.过滤器工厂
GatewayFilter是网关中提供的一种过滤器,可以对进入网关的请求和微服务返回的响应做处理:
3.4.1.路由过滤器的种类
Spring提供了31种不同的路由过滤器工厂。例如:
名称 说明 AddRequestHeader 给当前请求添加一个请求头 RemoveRequestHeader 移除请求中的一个请求头 AddResponseHeader 给响应结果中添加一个响应头 RemoveResponseHeader 从响应结果中移除有一个响应头 RequestRateLimiter 限制请求的流量 3.4.2.请求头过滤器
下面我们以AddRequestHeader 为例来讲解。
需求:给所有进入userservice的请求添加一个请求头:Truth=itcast is freaking awesome!
只需要修改gateway服务的application.yml文件,添加路由过滤即可:
spring:
  cloud:
    gateway:
      routes:
      - id: user-service
        uri: lb://userservice
        predicates:
        - Path=/user/**
        filters: # 过滤器
        - AddRequestHeader=Truth, Itcast is freaking awesome! # 添加请求头
当前过滤器写在userservice路由下,因此仅仅对访问userservice的请求有效。
3.4.3.默认过滤器
如果要对所有的路由都生效,则可以将过滤器工厂写到default下。格式如下:
spring:
  cloud:
    gateway:
      routes:
      - id: user-service
        uri: lb://userservice
        predicates:
        - Path=/user/**
      default-filters: # 默认过滤项
      - AddRequestHeader=Truth, Itcast is freaking awesome!
3.4.4.总结
过滤器的作用是什么?
① 对路由的请求或响应做加工处理,比如添加请求头
② 配置在路由下的过滤器只对当前路由的请求生效
defaultFilters的作用是什么?
① 对所有路由都生效的过滤器
3.5.全局过滤器
上一节学习的过滤器,网关提供了31种,但每一种过滤器的作用都是固定的。如果我们希望拦截请求,做自己的业务逻辑则没办法实现。
3.5.1.全局过滤器作用
全局过滤器的作用也是处理一切进入网关的请求和微服务响应,与GatewayFilter的作用一样。区别在于GatewayFilter通过配置定义,处理逻辑是固定的;而GlobalFilter的逻辑需要自己写代码实现。
定义方式是实现GlobalFilter接口。
public interface GlobalFilter {
    /**
     *  处理当前请求,有必要的话通过{@link GatewayFilterChain}将请求交给下一个过滤器处理
     *
     * @param exchange 请求上下文,里面可以获取Request、Response等信息
     * @param chain 用来把请求委托给下一个过滤器
     * @return {@code Mono<Void>} 返回标示当前过滤器业务结束
     */
    Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain);
}
在filter中编写自定义逻辑,可以实现下列功能:
- 登录状态判断
- 权限校验
- 请求限流等
3.5.2.自定义全局过滤器
需求:定义全局过滤器,拦截请求,判断请求的参数是否满足下面条件:
- 参数中是否有authorization,
- authorization参数值是否为admin
如果同时满足则放行,否则拦截
实现:
在gateway中定义一个过滤器:
package cn.itcast.gateway.filters;

import org.springframework.cloud.gateway.filter.GatewayFilterChain;
import org.springframework.cloud.gateway.filter.GlobalFilter;
import org.springframework.core.annotation.Order;
import org.springframework.http.HttpStatus;
import org.springframework.stereotype.Component;
import org.springframework.web.server.ServerWebExchange;
import reactor.core.publisher.Mono;

@Order(-1)
@Component
public class AuthorizeFilter implements GlobalFilter {
    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        // 1.获取请求参数
        MultiValueMap<String, String> params = exchange.getRequest().getQueryParams();
        // 2.获取authorization参数
        String auth = params.getFirst("authorization");
        // 3.校验
        if ("admin".equals(auth)) {
            // 放行
            return chain.filter(exchange);
        }
        // 4.拦截
        // 4.1.禁止访问,设置状态码
        exchange.getResponse().setStatusCode(HttpStatus.FORBIDDEN);
        // 4.2.结束处理
        return exchange.getResponse().setComplete();
    }
}
3.5.3.过滤器执行顺序
请求进入网关会碰到三类过滤器:当前路由的过滤器、DefaultFilter、GlobalFilter
请求路由后,会将当前路由过滤器和DefaultFilter、GlobalFilter,合并到一个过滤器链(集合)中,排序后依次执行每个过滤器:
排序的规则是什么呢?
- 每一个过滤器都必须指定一个int类型的order值,order值越小,优先级越高,执行顺序越靠前。
- GlobalFilter通过实现Ordered接口,或者添加@Order注解来指定order值,由我们自己指定
- 路由过滤器和defaultFilter的order由Spring指定,默认是按照声明顺序从1递增。
- 当过滤器的order值一样时,会按照 defaultFilter > 路由过滤器 > GlobalFilter的顺序执行。
详细内容,可以查看源码:
org.springframework.cloud.gateway.route.RouteDefinitionRouteLocator#getFilters()方法是先加载defaultFilters,然后再加载某个route的filters,然后合并。
org.springframework.cloud.gateway.handler.FilteringWebHandler#handle()方法会加载全局过滤器,与前面的过滤器合并后根据order排序,组织过滤器链3.6.跨域问题
3.6.1.什么是跨域问题
跨域:域名不一致就是跨域,主要包括:
- 域名不同: www.taobao.com 和 www.taobao.org 和 www.jd.com 和 miaosha.jd.com
- 域名相同,端口不同:localhost:8080和localhost8081
跨域问题:浏览器禁止请求的发起者与服务端发生跨域ajax请求,请求被浏览器拦截的问题
解决方案:CORS,这个以前应该学习过,这里不再赘述了。不知道的小伙伴可以查看https://www.ruanyifeng.com/blog/2016/04/cors.html
3.6.2.模拟跨域问题
找到课前资料的页面文件:
放入tomcat或者nginx这样的web服务器中,启动并访问。
可以在浏览器控制台看到下面的错误:
从localhost:8090访问localhost:10010,端口不同,显然是跨域的请求。
3.6.3.解决跨域问题
在gateway服务的application.yml文件中,添加下面的配置:
spring:
  cloud:
    gateway:
      # 。。。
      globalcors: # 全局的跨域处理
        add-to-simple-url-handler-mapping: true # 解决options请求被拦截问题
        corsConfigurations:
          '[/**]':
            allowedOrigins: # 允许哪些网站的跨域请求
              - "http://localhost:8090"
            allowedMethods: # 允许的跨域ajax的请求方式
              - "GET"
              - "POST"
              - "DELETE"
              - "PUT"
              - "OPTIONS"
            allowedHeaders: "*" # 允许在请求中携带的头信息
            allowCredentials: true # 是否允许携带cookie
            maxAge: 360000 # 这次跨域检测的有效期


1.初识elasticsearch
1.1.了解ES
1.1.1.elasticsearch的作用
elasticsearch是一款非常强大的开源搜索引擎,具备非常多强大功能,可以帮助我们从海量数据中快速找到需要的内容
例如:
在GitHub搜索代码
在电商网站搜索商品
在百度搜索答案
在打车软件搜索附近的车
1.1.2.ELK技术栈
elasticsearch结合kibana、Logstash、Beats,也就是elastic stack(ELK)。被广泛应用在日志数据分析、实时监控等领域:
而elasticsearch是elastic stack的核心,负责存储、搜索、分析数据。
1.1.3.elasticsearch和lucene
elasticsearch底层是基于lucene来实现的。
Lucene是一个Java语言的搜索引擎类库,是Apache公司的顶级项目,由DougCutting于1999年研发。官网地址:https://lucene.apache.org/ 。
elasticsearch的发展历史:
2004年Shay Banon基于Lucene开发了Compass
2010年Shay Banon 重写了Compass,取名为Elasticsearch。
1.1.4.为什么不是其他搜索技术?
目前比较知名的搜索引擎技术排名:
虽然在早期,Apache Solr是最主要的搜索引擎技术,但随着发展elasticsearch已经渐渐超越了Solr,独占鳌头:
1.1.5.总结
什么是elasticsearch?
- 一个开源的分布式搜索引擎,可以用来实现搜索、日志统计、分析、系统监控等功能
什么是elastic stack(ELK)?
- 是以elasticsearch为核心的技术栈,包括beats、Logstash、kibana、elasticsearch
什么是Lucene?
- 是Apache的开源搜索引擎类库,提供了搜索引擎的核心API
1.2.倒排索引
倒排索引的概念是基于MySQL这样的正向索引而言的。
1.2.1.正向索引
那么什么是正向索引呢?例如给下表(tb_goods)中的id创建索引:
如果是根据id查询,那么直接走索引,查询速度非常快。
但如果是基于title做模糊查询,只能是逐行扫描数据,流程如下:
1)用户搜索数据,条件是title符合
"%手机%"2)逐行获取数据,比如id为1的数据
3)判断数据中的title是否符合用户搜索条件
4)如果符合则放入结果集,不符合则丢弃。回到步骤1
逐行扫描,也就是全表扫描,随着数据量增加,其查询效率也会越来越低。当数据量达到数百万时,就是一场灾难。
1.2.2.倒排索引
倒排索引中有两个非常重要的概念:
- 文档(
Document):用来搜索的数据,其中的每一条数据就是一个文档。例如一个网页、一个商品信息- 词条(
Term):对文档数据或用户搜索数据,利用某种算法分词,得到的具备含义的词语就是词条。例如:我是中国人,就可以分为:我、是、中国人、中国、国人这样的几个词条创建倒排索引是对正向索引的一种特殊处理,流程如下:
- 将每一个文档的数据利用算法分词,得到一个个词条
- 创建表,每行数据包括词条、词条所在文档id、位置等信息
- 因为词条唯一性,可以给词条创建索引,例如hash表结构索引
如图:
倒排索引的搜索流程如下(以搜索"华为手机"为例):
1)用户输入条件
"华为手机"进行搜索。2)对用户输入内容分词,得到词条:
华为、手机。3)拿着词条在倒排索引中查找,可以得到包含词条的文档id:1、2、3。
4)拿着文档id到正向索引中查找具体文档。
如图:
虽然要先查询倒排索引,再查询倒排索引,但是无论是词条、还是文档id都建立了索引,查询速度非常快!无需全表扫描。
1.2.3.正向和倒排
那么为什么一个叫做正向索引,一个叫做倒排索引呢?
- 正向索引是最传统的,根据id索引的方式。但根据词条查询时,必须先逐条获取每个文档,然后判断文档中是否包含所需要的词条,是根据文档找词条的过程。
- 而倒排索引则相反,是先找到用户要搜索的词条,根据词条得到保护词条的文档的id,然后根据id获取文档。是根据词条找文档的过程。
是不是恰好反过来了?
那么两者方式的优缺点是什么呢?
正向索引:
- 优点:
- 可以给多个字段创建索引
- 根据索引字段搜索、排序速度非常快
- 缺点:
- 根据非索引字段,或者索引字段中的部分词条查找时,只能全表扫描。
倒排索引:
- 优点:
- 根据词条搜索、模糊搜索时,速度非常快
- 缺点:
- 只能给词条创建索引,而不是字段
- 无法根据字段做排序
1.3.es的一些概念
elasticsearch中有很多独有的概念,与mysql中略有差别,但也有相似之处。
1.3.1.文档和字段
elasticsearch是面向文档(Document)存储的,可以是数据库中的一条商品数据,一个订单信息。文档数据会被序列化为json格式后存储在elasticsearch中:
而Json文档中往往包含很多的字段(Field) ,类似于数据库中的列。
1.3.2.索引和映射
索引(Index) ,就是相同类型的文档的集合。
例如:
所有用户文档,就可以组织在一起,称为用户的索引;
所有商品的文档,可以组织在一起,称为商品的索引;
所有订单的文档,可以组织在一起,称为订单的索引;
因此,我们可以把索引当做是数据库中的表。
数据库的表会有约束信息,用来定义表的结构、字段的名称、类型等信息。因此,索引库中就有映射(mapping) ,是索引中文档的字段约束信息,类似表的结构约束。
1.3.3.mysql与elasticsearch
我们统一的把mysql与elasticsearch的概念做一下对比:
MySQL Elasticsearch 说明 Table Index 索引(index),就是文档的集合,类似数据库的表(table) Row Document 文档(Document),就是一条条的数据,类似数据库中的行(Row),文档都是JSON格式 Column Field 字段(Field),就是JSON文档中的字段,类似数据库中的列(Column) Schema Mapping Mapping(映射)是索引中文档的约束,例如字段类型约束。类似数据库的表结构(Schema) SQL DSL DSL是elasticsearch提供的JSON风格的请求语句,用来操作elasticsearch,实现CRUD 是不是说,我们学习了elasticsearch就不再需要mysql了呢?
并不是如此,两者各自有自己的擅长支出:
- Mysql:擅长事务类型操作,可以确保数据的安全和一致性
- Elasticsearch:擅长海量数据的搜索、分析、计算
因此在企业中,往往是两者结合使用:
对安全性要求较高的写操作,使用mysql实现
对查询性能要求较高的搜索需求,使用elasticsearch实现
两者再基于某种方式,实现数据的同步,保证一致性
1.4.安装es、kibana
1.4.1.安装
参考课前资料:
1.4.2.分词器
参考课前资料:
1.4.3.总结
分词器的作用是什么?
- 创建倒排索引时对文档分词
- 用户搜索时,对输入的内容分词
IK分词器有几种模式?
- ik_smart:智能切分,粗粒度
- ik_max_word:最细切分,细粒度
IK分词器如何拓展词条?如何停用词条?
- 利用config目录的IkAnalyzer.cfg.xml文件添加拓展词典和停用词典
- 在词典中添加拓展词条或者停用词条
2.索引库操作
索引库就类似数据库表,mapping映射就类似表的结构。
我们要向es中存储数据,必须先创建“库”和“表”。
2.1.mapping映射属性
mapping是对索引库中文档的约束,常见的mapping属性包括:
- type:字段数据类型,常见的简单类型有:
- 字符串:text(可分词的文本)、keyword(精确值,例如:品牌、国家、ip地址)
- 数值:long、integer、short、byte、double、float、
- 布尔:boolean
- 日期:date
- 对象:object
- index:是否创建索引,默认为true
- analyzer:使用哪种分词器
- properties:该字段的子字段
例如下面的json文档:
{
    "age": 21,
    "weight": 52.1,
    "isMarried": false,
    "info": "黑马程序员Java讲师",
    "email": "zy@itcast.cn",
    "score": [99.1, 99.5, 98.9],
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
对应的每个字段映射(mapping):
- age:类型为 integer;参与搜索,因此需要index为true;无需分词器
- weight:类型为float;参与搜索,因此需要index为true;无需分词器
- isMarried:类型为boolean;参与搜索,因此需要index为true;无需分词器
- info:类型为字符串,需要分词,因此是text;参与搜索,因此需要index为true;分词器可以用ik_smart
- email:类型为字符串,但是不需要分词,因此是keyword;不参与搜索,因此需要index为false;无需分词器
- score:虽然是数组,但是我们只看元素的类型,类型为float;参与搜索,因此需要index为true;无需分词器
- name:类型为object,需要定义多个子属性
- name.firstName;类型为字符串,但是不需要分词,因此是keyword;参与搜索,因此需要index为true;无需分词器
- name.lastName;类型为字符串,但是不需要分词,因此是keyword;参与搜索,因此需要index为true;无需分词器
2.2.索引库的CRUD
这里我们统一使用Kibana编写DSL的方式来演示。
2.2.1.创建索引库和映射
基本语法:
- 请求方式:PUT
- 请求路径:/索引库名,可以自定义
- 请求参数:mapping映射
格式:
PUT /索引库名称
{
  "mappings": {
    "properties": {
      "字段名":{
        "type": "text",
        "analyzer": "ik_smart"
      },
      "字段名2":{
        "type": "keyword",
        "index": "false"
      },
      "字段名3":{
        "properties": {
          "子字段": {
            "type": "keyword"
          }
        }
      },
      // ...略
    }
  }
}
示例:
PUT /heima
{
  "mappings": {
    "properties": {
      "info":{
        "type": "text",
        "analyzer": "ik_smart"
      },
      "email":{
        "type": "keyword",
        "index": "falsae"
      },
      "name":{
        "properties": {
          "firstName": {
            "type": "keyword"
          }
        }
      },
      // ... 略
    }
  }
}
2.2.2.查询索引库
基本语法:
- 请求方式:GET
- 请求路径:/索引库名
- 请求参数:无
格式:
GET /索引库名示例:
2.2.3.修改索引库
倒排索引结构虽然不复杂,但是一旦数据结构改变(比如改变了分词器),就需要重新创建倒排索引,这简直是灾难。因此索引库一旦创建,无法修改mapping。
虽然无法修改mapping中已有的字段,但是却允许添加新的字段到mapping中,因为不会对倒排索引产生影响。
语法说明:
PUT /索引库名/_mapping { "properties": { "新字段名":{ "type": "integer" } } }示例:
2.2.4.删除索引库
语法:
- 请求方式:DELETE
- 请求路径:/索引库名
- 请求参数:无
格式:
DELETE /索引库名在kibana中测试:
2.2.5.总结
索引库操作有哪些?
- 创建索引库:PUT /索引库名
- 查询索引库:GET /索引库名
- 删除索引库:DELETE /索引库名
- 添加字段:PUT /索引库名/_mapping
3.文档操作
3.1.新增文档
语法:
POST /索引库名/_doc/文档id
{
    "字段1": "值1",
    "字段2": "值2",
    "字段3": {
        "子属性1": "值3",
        "子属性2": "值4"
    },
    // ...
}
示例:
POST /heima/_doc/1
{
    "info": "黑马程序员Java讲师",
    "email": "zy@itcast.cn",
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
响应:
3.2.查询文档
根据rest风格,新增是post,查询应该是get,不过查询一般都需要条件,这里我们把文档id带上。
语法:
GET /{索引库名称}/_doc/{id}通过kibana查看数据:
GET /heima/_doc/1查看结果:
3.3.删除文档
删除使用DELETE请求,同样,需要根据id进行删除:
语法:
DELETE /{索引库名}/_doc/id值示例:
# 根据id删除数据
DELETE /heima/_doc/1
结果:
3.4.修改文档
修改有两种方式:
- 全量修改:直接覆盖原来的文档
- 增量修改:修改文档中的部分字段
3.4.1.全量修改
全量修改是覆盖原来的文档,其本质是:
- 根据指定的id删除文档
- 新增一个相同id的文档
注意:如果根据id删除时,id不存在,第二步的新增也会执行,也就从修改变成了新增操作了。
语法:
PUT /{索引库名}/_doc/文档id
{
    "字段1": "值1",
    "字段2": "值2",
    // ... 略
}
示例:
PUT /heima/_doc/1
{
    "info": "黑马程序员高级Java讲师",
    "email": "zy@itcast.cn",
    "name": {
        "firstName": "云",
        "lastName": "赵"
    }
}
3.4.2.增量修改
增量修改是只修改指定id匹配的文档中的部分字段。
语法:
POST /{索引库名}/_update/文档id
{
    "doc": {
         "字段名": "新的值",
    }
}
示例:
POST /heima/_update/1
{
  "doc": {
    "email": "ZhaoYun@itcast.cn"
  }
}
3.5.总结
文档操作有哪些?
- 创建文档:POST /{索引库名}/_doc/文档id { json文档 }
- 查询文档:GET /{索引库名}/_doc/文档id
- 删除文档:DELETE /{索引库名}/_doc/文档id
- 修改文档:
- 全量修改:PUT /{索引库名}/_doc/文档id { json文档 }
- 增量修改:POST /{索引库名}/_update/文档id { “doc”: {字段}}
4.RestAPI
ES官方提供了各种不同语言的客户端,用来操作ES。这些客户端的本质就是组装DSL语句,通过http请求发送给ES。官方文档地址:https://www.elastic.co/guide/en/elasticsearch/client/index.html
其中的Java Rest Client又包括两种:
Java Low Level Rest Client
Java High Level Rest Client
我们学习的是Java HighLevel Rest Client客户端API
4.0.导入Demo工程
4.0.1.导入数据
首先导入课前资料提供的数据库数据:
数据结构如下:
CREATE TABLE `tb_hotel` (
  `id` bigint(20) NOT NULL COMMENT '酒店id',
  `name` varchar(255) NOT NULL COMMENT '酒店名称;例:7天酒店',
  `address` varchar(255) NOT NULL COMMENT '酒店地址;例:航头路',
  `price` int(10) NOT NULL COMMENT '酒店价格;例:329',
  `score` int(2) NOT NULL COMMENT '酒店评分;例:45,就是4.5分',
  `brand` varchar(32) NOT NULL COMMENT '酒店品牌;例:如家',
  `city` varchar(32) NOT NULL COMMENT '所在城市;例:上海',
  `star_name` varchar(16) DEFAULT NULL COMMENT '酒店星级,从低到高分别是:1星到5星,1钻到5钻',
  `business` varchar(255) DEFAULT NULL COMMENT '商圈;例:虹桥',
  `latitude` varchar(32) NOT NULL COMMENT '纬度;例:31.2497',
  `longitude` varchar(32) NOT NULL COMMENT '经度;例:120.3925',
  `pic` varchar(255) DEFAULT NULL COMMENT '酒店图片;例:/img/1.jpg',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
4.0.2.导入项目
然后导入课前资料提供的项目:
项目结构如图:
4.0.3.mapping映射分析
创建索引库,最关键的是mapping映射,而mapping映射要考虑的信息包括:
- 字段名
- 字段数据类型
- 是否参与搜索
- 是否需要分词
- 如果分词,分词器是什么?
其中:
- 字段名、字段数据类型,可以参考数据表结构的名称和类型
- 是否参与搜索要分析业务来判断,例如图片地址,就无需参与搜索
- 是否分词呢要看内容,内容如果是一个整体就无需分词,反之则要分词
- 分词器,我们可以统一使用ik_max_word
来看下酒店数据的索引库结构:
PUT /hotel
{
  "mappings": {
    "properties": {
      "id": {
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "ik_max_word",
        "copy_to": "all"
      },
      "address":{
        "type": "keyword",
        "index": false
      },
      "price":{
        "type": "integer"
      },
      "score":{
        "type": "integer"
      },
      "brand":{
        "type": "keyword",
        "copy_to": "all"
      },
      "city":{
        "type": "keyword",
        "copy_to": "all"
      },
      "starName":{
        "type": "keyword"
      },
      "business":{
        "type": "keyword"
      },
      "location":{
        "type": "geo_point"
      },
      "pic":{
        "type": "keyword",
        "index": false
      },
      "all":{
        "type": "text",
        "analyzer": "ik_max_word"
      }
    }
  }
}
几个特殊字段说明:
- location:地理坐标,里面包含精度、纬度
- all:一个组合字段,其目的是将多字段的值 利用copy_to合并,提供给用户搜索
地理坐标说明:
copy_to说明:
4.0.4.初始化RestClient
在elasticsearch提供的API中,与elasticsearch一切交互都封装在一个名为RestHighLevelClient的类中,必须先完成这个对象的初始化,建立与elasticsearch的连接。
分为三步:
1)引入es的RestHighLevelClient依赖:
<dependency>
    <groupId>org.elasticsearch.client</groupId>
    <artifactId>elasticsearch-rest-high-level-client</artifactId>
</dependency>
2)因为SpringBoot默认的ES版本是7.6.2,所以我们需要覆盖默认的ES版本:
<properties>
    <java.version>1.8</java.version>
    <elasticsearch.version>7.12.1</elasticsearch.version>
</properties>
3)初始化RestHighLevelClient:
初始化的代码如下:
RestHighLevelClient client = new RestHighLevelClient(RestClient.builder(
        HttpHost.create("http://192.168.150.101:9200")
));
这里为了单元测试方便,我们创建一个测试类HotelIndexTest,然后将初始化的代码编写在@BeforeEach方法中:
package cn.itcast.hotel;

import org.apache.http.HttpHost;
import org.elasticsearch.client.RestHighLevelClient;
import org.junit.jupiter.api.AfterEach;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.Test;

import java.io.IOException;

public class HotelIndexTest {
    private RestHighLevelClient client;

    @BeforeEach
    void setUp() {
        this.client = new RestHighLevelClient(RestClient.builder(
                HttpHost.create("http://192.168.150.101:9200")
        ));
    }

    @AfterEach
    void tearDown() throws IOException {
        this.client.close();
    }
}
4.1.创建索引库
4.1.1.代码解读
创建索引库的API如下:
代码分为三步:
- 1)创建Request对象。因为是创建索引库的操作,因此Request是CreateIndexRequest。
- 2)添加请求参数,其实就是DSL的JSON参数部分。因为json字符串很长,这里是定义了静态字符串常量MAPPING_TEMPLATE,让代码看起来更加优雅。
- 3)发送请求,client.indices()方法的返回值是IndicesClient类型,封装了所有与索引库操作有关的方法。
4.1.2.完整示例
在hotel-demo的cn.itcast.hotel.constants包下,创建一个类,定义mapping映射的JSON字符串常量:
package cn.itcast.hotel.constants;

public class HotelConstants {
    public static final String MAPPING_TEMPLATE = "{\n" +
            "  \"mappings\": {\n" +
            "    \"properties\": {\n" +
            "      \"id\": {\n" +
            "        \"type\": \"keyword\"\n" +
            "      },\n" +
            "      \"name\":{\n" +
            "        \"type\": \"text\",\n" +
            "        \"analyzer\": \"ik_max_word\",\n" +
            "        \"copy_to\": \"all\"\n" +
            "      },\n" +
            "      \"address\":{\n" +
            "        \"type\": \"keyword\",\n" +
            "        \"index\": false\n" +
            "      },\n" +
            "      \"price\":{\n" +
            "        \"type\": \"integer\"\n" +
            "      },\n" +
            "      \"score\":{\n" +
            "        \"type\": \"integer\"\n" +
            "      },\n" +
            "      \"brand\":{\n" +
            "        \"type\": \"keyword\",\n" +
            "        \"copy_to\": \"all\"\n" +
            "      },\n" +
            "      \"city\":{\n" +
            "        \"type\": \"keyword\",\n" +
            "        \"copy_to\": \"all\"\n" +
            "      },\n" +
            "      \"starName\":{\n" +
            "        \"type\": \"keyword\"\n" +
            "      },\n" +
            "      \"business\":{\n" +
            "        \"type\": \"keyword\"\n" +
            "      },\n" +
            "      \"location\":{\n" +
            "        \"type\": \"geo_point\"\n" +
            "      },\n" +
            "      \"pic\":{\n" +
            "        \"type\": \"keyword\",\n" +
            "        \"index\": false\n" +
            "      },\n" +
            "      \"all\":{\n" +
            "        \"type\": \"text\",\n" +
            "        \"analyzer\": \"ik_max_word\"\n" +
            "      }\n" +
            "    }\n" +
            "  }\n" +
            "}";
}
在hotel-demo中的HotelIndexTest测试类中,编写单元测试,实现创建索引:
@Test
void createHotelIndex() throws IOException {
    // 1.创建Request对象
    CreateIndexRequest request = new CreateIndexRequest("hotel");
    // 2.准备请求的参数:DSL语句
    request.source(MAPPING_TEMPLATE, XContentType.JSON);
    // 3.发送请求
    client.indices().create(request, RequestOptions.DEFAULT);
}
4.2.删除索引库
删除索引库的DSL语句非常简单:
DELETE /hotel与创建索引库相比:
- 请求方式从PUT变为DELTE
- 请求路径不变
- 无请求参数
所以代码的差异,注意体现在Request对象上。依然是三步走:
- 1)创建Request对象。这次是DeleteIndexRequest对象
- 2)准备参数。这里是无参
- 3)发送请求。改用delete方法
在hotel-demo中的HotelIndexTest测试类中,编写单元测试,实现删除索引:
@Test
void testDeleteHotelIndex() throws IOException {
    // 1.创建Request对象
    DeleteIndexRequest request = new DeleteIndexRequest("hotel");
    // 2.发送请求
    client.indices().delete(request, RequestOptions.DEFAULT);
}
4.3.判断索引库是否存在
判断索引库是否存在,本质就是查询,对应的DSL是:
GET /hotel因此与删除的Java代码流程是类似的。依然是三步走:
- 1)创建Request对象。这次是GetIndexRequest对象
- 2)准备参数。这里是无参
- 3)发送请求。改用exists方法
@Test
void testExistsHotelIndex() throws IOException {
    // 1.创建Request对象
    GetIndexRequest request = new GetIndexRequest("hotel");
    // 2.发送请求
    boolean exists = client.indices().exists(request, RequestOptions.DEFAULT);
    // 3.输出
    System.err.println(exists ? "索引库已经存在!" : "索引库不存在!");
}
4.4.总结
JavaRestClient操作elasticsearch的流程基本类似。核心是client.indices()方法来获取索引库的操作对象。
索引库操作的基本步骤:
- 初始化RestHighLevelClient
- 创建XxxIndexRequest。XXX是Create、Get、Delete
- 准备DSL( Create时需要,其它是无参)
- 发送请求。调用RestHighLevelClient#indices().xxx()方法,xxx是create、exists、delete
5.RestClient操作文档
为了与索引库操作分离,我们再次参加一个测试类,做两件事情:
- 初始化RestHighLevelClient
- 我们的酒店数据在数据库,需要利用IHotelService去查询,所以注入这个接口
package cn.itcast.hotel;

import cn.itcast.hotel.pojo.Hotel;
import cn.itcast.hotel.service.IHotelService;
import org.junit.jupiter.api.AfterEach;
import org.junit.jupiter.api.BeforeEach;
import org.junit.jupiter.api.Test;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

import java.io.IOException;
import java.util.List;

@SpringBootTest
public class HotelDocumentTest {
    @Autowired
    private IHotelService hotelService;

    private RestHighLevelClient client;

    @BeforeEach
    void setUp() {
        this.client = new RestHighLevelClient(RestClient.builder(
                HttpHost.create("http://192.168.150.101:9200")
        ));
    }

    @AfterEach
    void tearDown() throws IOException {
        this.client.close();
    }
}
5.1.新增文档
我们要将数据库的酒店数据查询出来,写入elasticsearch中。
5.1.1.索引库实体类
数据库查询后的结果是一个Hotel类型的对象。结构如下:
@Data
@TableName("tb_hotel")
public class Hotel {
    @TableId(type = IdType.INPUT)
    private Long id;
    private String name;
    private String address;
    private Integer price;
    private Integer score;
    private String brand;
    private String city;
    private String starName;
    private String business;
    private String longitude;
    private String latitude;
    private String pic;
}
与我们的索引库结构存在差异:
- longitude和latitude需要合并为location
因此,我们需要定义一个新的类型,与索引库结构吻合:
package cn.itcast.hotel.pojo;

import lombok.Data;
import lombok.NoArgsConstructor;

@Data
@NoArgsConstructor
public class HotelDoc {
    private Long id;
    private String name;
    private String address;
    private Integer price;
    private Integer score;
    private String brand;
    private String city;
    private String starName;
    private String business;
    private String location;
    private String pic;

    public HotelDoc(Hotel hotel) {
        this.id = hotel.getId();
        this.name = hotel.getName();
        this.address = hotel.getAddress();
        this.price = hotel.getPrice();
        this.score = hotel.getScore();
        this.brand = hotel.getBrand();
        this.city = hotel.getCity();
        this.starName = hotel.getStarName();
        this.business = hotel.getBusiness();
        this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
        this.pic = hotel.getPic();
    }
}
5.1.2.语法说明
新增文档的DSL语句如下:
POST /{索引库名}/_doc/1
{
    "name": "Jack",
    "age": 21
}
对应的java代码如图:
可以看到与创建索引库类似,同样是三步走:
- 1)创建Request对象
- 2)准备请求参数,也就是DSL中的JSON文档
- 3)发送请求
变化的地方在于,这里直接使用client.xxx()的API,不再需要client.indices()了。
5.1.3.完整代码
我们导入酒店数据,基本流程一致,但是需要考虑几点变化:
- 酒店数据来自于数据库,我们需要先查询出来,得到hotel对象
- hotel对象需要转为HotelDoc对象
- HotelDoc需要序列化为json格式
因此,代码整体步骤如下:
- 1)根据id查询酒店数据Hotel
- 2)将Hotel封装为HotelDoc
- 3)将HotelDoc序列化为JSON
- 4)创建IndexRequest,指定索引库名和id
- 5)准备请求参数,也就是JSON文档
- 6)发送请求
在hotel-demo的HotelDocumentTest测试类中,编写单元测试:
@Test
void testAddDocument() throws IOException {
    // 1.根据id查询酒店数据
    Hotel hotel = hotelService.getById(61083L);
    // 2.转换为文档类型
    HotelDoc hotelDoc = new HotelDoc(hotel);
    // 3.将HotelDoc转json
    String json = JSON.toJSONString(hotelDoc);

    // 1.准备Request对象
    IndexRequest request = new IndexRequest("hotel").id(hotelDoc.getId().toString());
    // 2.准备Json文档
    request.source(json, XContentType.JSON);
    // 3.发送请求
    client.index(request, RequestOptions.DEFAULT);
}
5.2.查询文档
5.2.1.语法说明
查询的DSL语句如下:
GET /hotel/_doc/{id}非常简单,因此代码大概分两步:
- 准备Request对象
- 发送请求
不过查询的目的是得到结果,解析为HotelDoc,因此难点是结果的解析。完整代码如下:
可以看到,结果是一个JSON,其中文档放在一个
_source属性中,因此解析就是拿到_source,反序列化为Java对象即可。与之前类似,也是三步走:
- 1)准备Request对象。这次是查询,所以是GetRequest
- 2)发送请求,得到结果。因为是查询,这里调用client.get()方法
- 3)解析结果,就是对JSON做反序列化
5.2.2.完整代码
在hotel-demo的HotelDocumentTest测试类中,编写单元测试:
@Test
void testGetDocumentById() throws IOException {
    // 1.准备Request
    GetRequest request = new GetRequest("hotel", "61082");
    // 2.发送请求,得到响应
    GetResponse response = client.get(request, RequestOptions.DEFAULT);
    // 3.解析响应结果
    String json = response.getSourceAsString();

    HotelDoc hotelDoc = JSON.parseObject(json, HotelDoc.class);
    System.out.println(hotelDoc);
}
5.3.删除文档
删除的DSL为是这样的:
DELETE /hotel/_doc/{id}与查询相比,仅仅是请求方式从DELETE变成GET,可以想象Java代码应该依然是三步走:
- 1)准备Request对象,因为是删除,这次是DeleteRequest对象。要指定索引库名和id
- 2)准备参数,无参
- 3)发送请求。因为是删除,所以是client.delete()方法
在hotel-demo的HotelDocumentTest测试类中,编写单元测试:
@Test
void testDeleteDocument() throws IOException {
    // 1.准备Request
    DeleteRequest request = new DeleteRequest("hotel", "61083");
    // 2.发送请求
    client.delete(request, RequestOptions.DEFAULT);
}
5.4.修改文档
5.4.1.语法说明
修改我们讲过两种方式:
- 全量修改:本质是先根据id删除,再新增
- 增量修改:修改文档中的指定字段值
在RestClient的API中,全量修改与新增的API完全一致,判断依据是ID:
- 如果新增时,ID已经存在,则修改
- 如果新增时,ID不存在,则新增
这里不再赘述,我们主要关注增量修改。
代码示例如图:
与之前类似,也是三步走:
- 1)准备Request对象。这次是修改,所以是UpdateRequest
- 2)准备参数。也就是JSON文档,里面包含要修改的字段
- 3)更新文档。这里调用client.update()方法
5.4.2.完整代码
在hotel-demo的HotelDocumentTest测试类中,编写单元测试:
@Test
void testUpdateDocument() throws IOException {
    // 1.准备Request
    UpdateRequest request = new UpdateRequest("hotel", "61083");
    // 2.准备请求参数
    request.doc(
        "price", "952",
        "starName", "四钻"
    );
    // 3.发送请求
    client.update(request, RequestOptions.DEFAULT);
}
5.5.批量导入文档
案例需求:利用BulkRequest批量将数据库数据导入到索引库中。
步骤如下:
- 利用mybatis-plus查询酒店数据
- 将查询到的酒店数据(Hotel)转换为文档类型数据(HotelDoc)
- 利用JavaRestClient中的BulkRequest批处理,实现批量新增文档
5.5.1.语法说明
批量处理BulkRequest,其本质就是将多个普通的CRUD请求组合在一起发送。
其中提供了一个add方法,用来添加其他请求:
可以看到,能添加的请求包括:
- IndexRequest,也就是新增
- UpdateRequest,也就是修改
- DeleteRequest,也就是删除
因此Bulk中添加了多个IndexRequest,就是批量新增功能了。示例:
其实还是三步走:
- 1)创建Request对象。这里是BulkRequest
- 2)准备参数。批处理的参数,就是其它Request对象,这里就是多个IndexRequest
- 3)发起请求。这里是批处理,调用的方法为client.bulk()方法
我们在导入酒店数据时,将上述代码改造成for循环处理即可。
5.5.2.完整代码
在hotel-demo的HotelDocumentTest测试类中,编写单元测试:
@Test
void testBulkRequest() throws IOException {
    // 批量查询酒店数据
    List<Hotel> hotels = hotelService.list();

    // 1.创建Request
    BulkRequest request = new BulkRequest();
    // 2.准备参数,添加多个新增的Request
    for (Hotel hotel : hotels) {
        // 2.1.转换为文档类型HotelDoc
        HotelDoc hotelDoc = new HotelDoc(hotel);
        // 2.2.创建新增文档的Request对象
        request.add(new IndexRequest("hotel")
                    .id(hotelDoc.getId().toString())
                    .source(JSON.toJSONString(hotelDoc), XContentType.JSON));
    }
    // 3.发送请求
    client.bulk(request, RequestOptions.DEFAULT);
}
5.6.小结
文档操作的基本步骤:
- 初始化RestHighLevelClient
- 创建XxxRequest。XXX是Index、Get、Update、Delete、Bulk
- 准备参数(Index、Update、Bulk时需要)
- 发送请求。调用RestHighLevelClient#.xxx()方法,xxx是index、get、update、delete、bulk
- 解析结果(Get时需要)
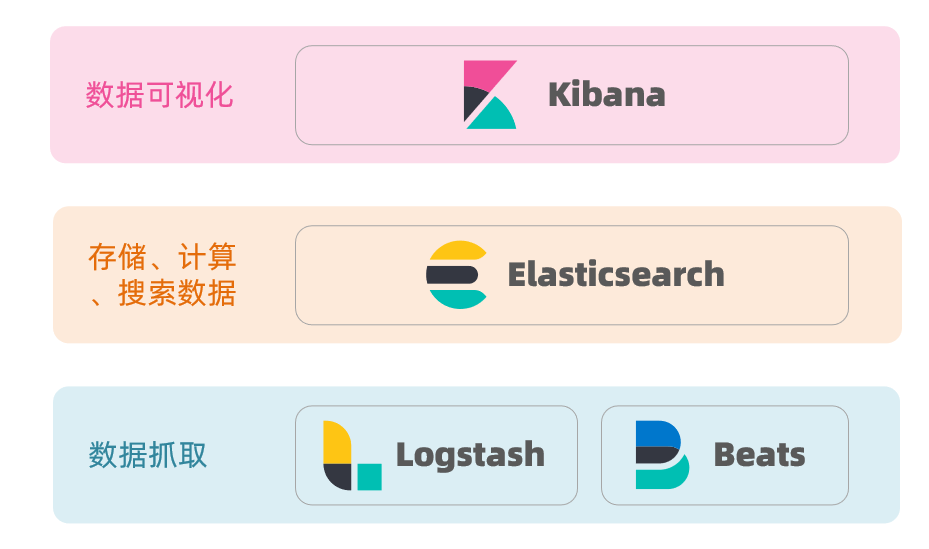
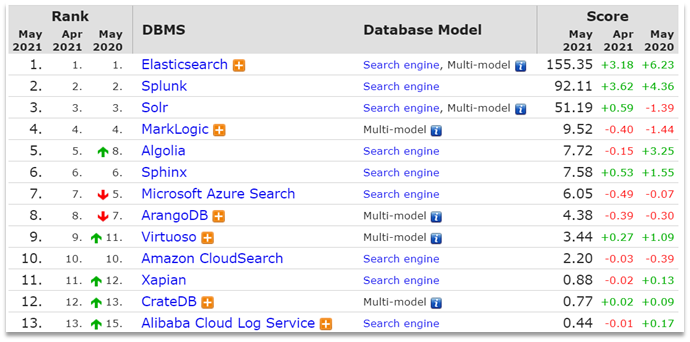
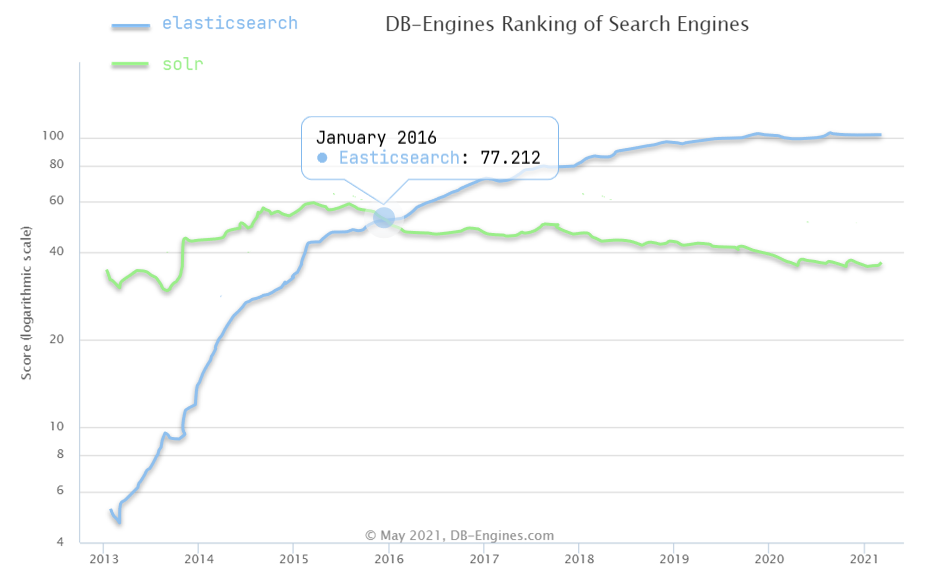
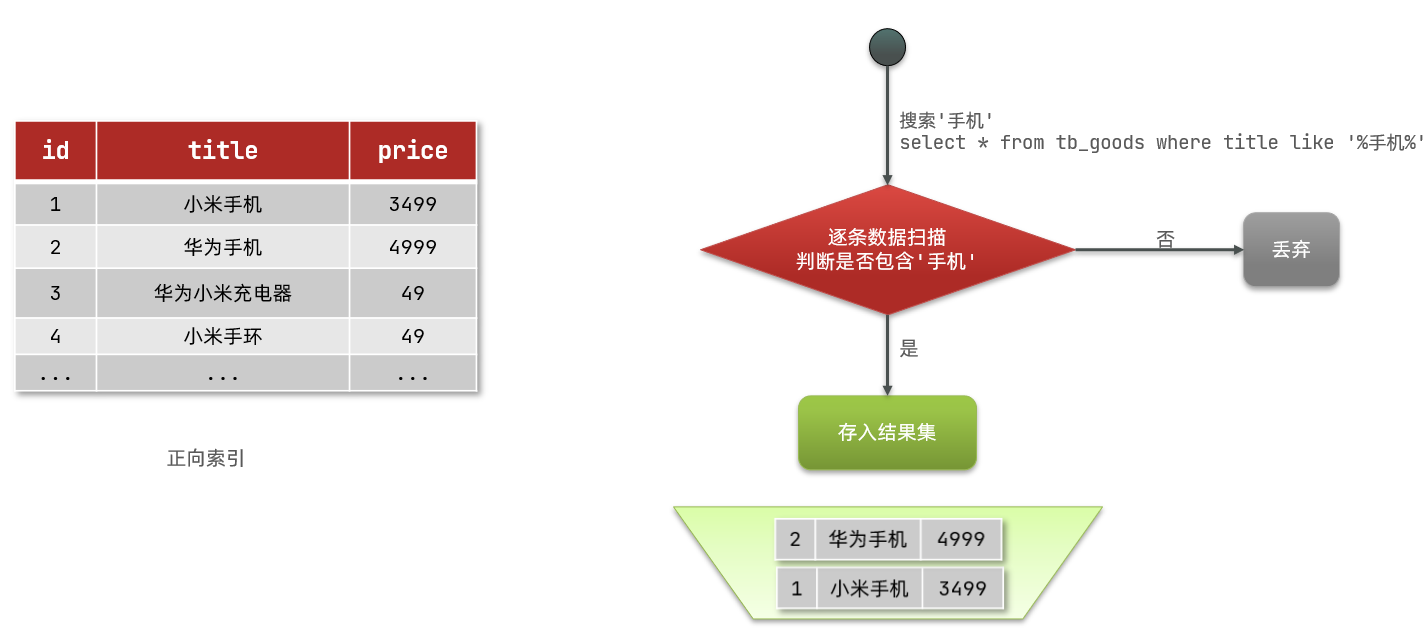
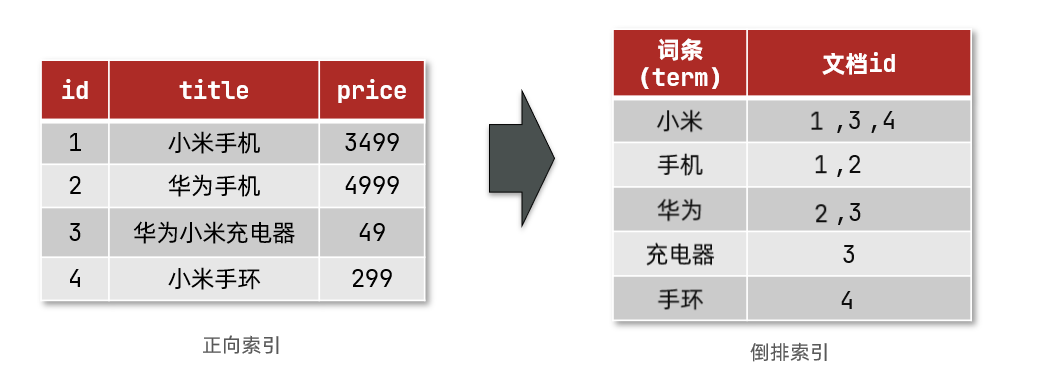

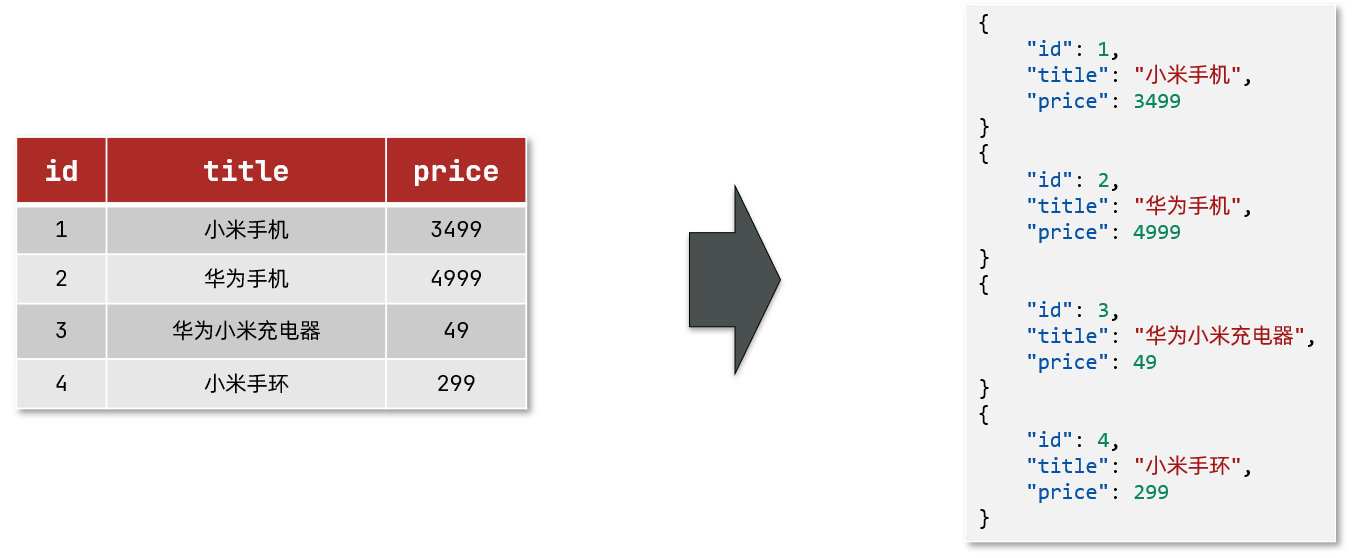
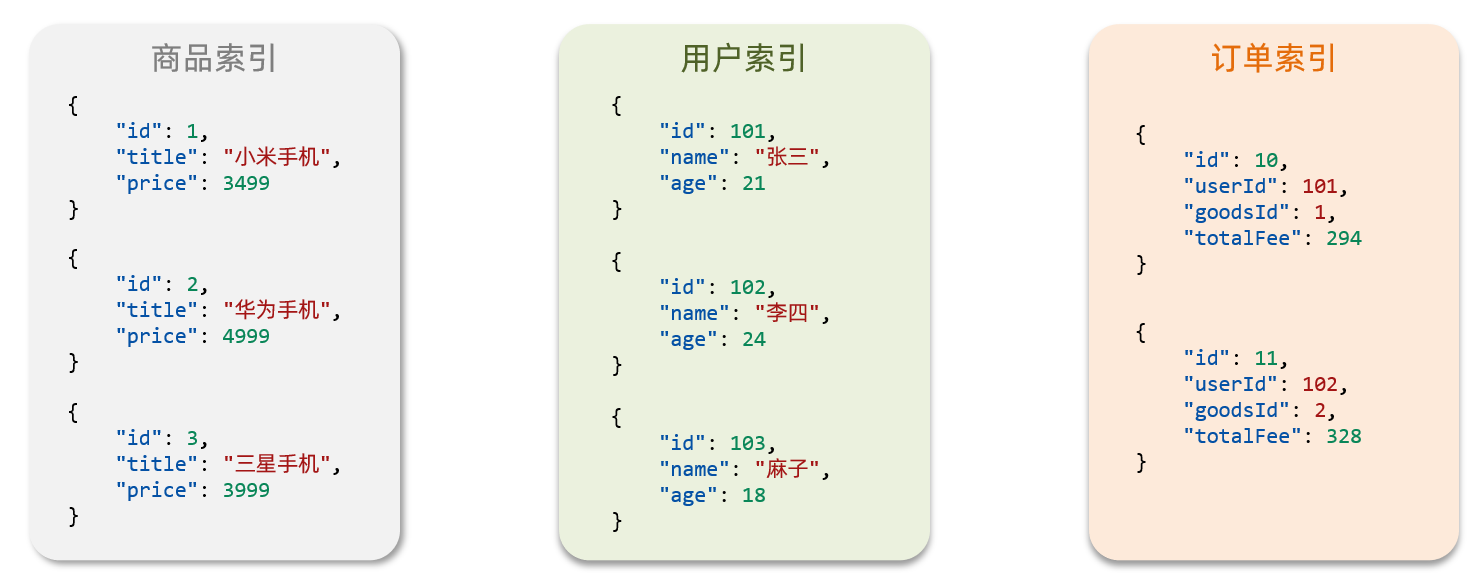


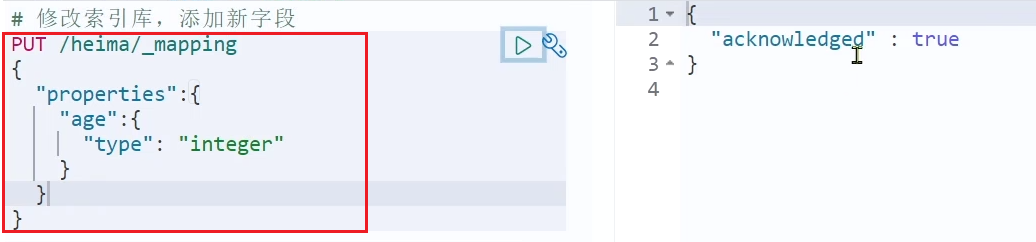


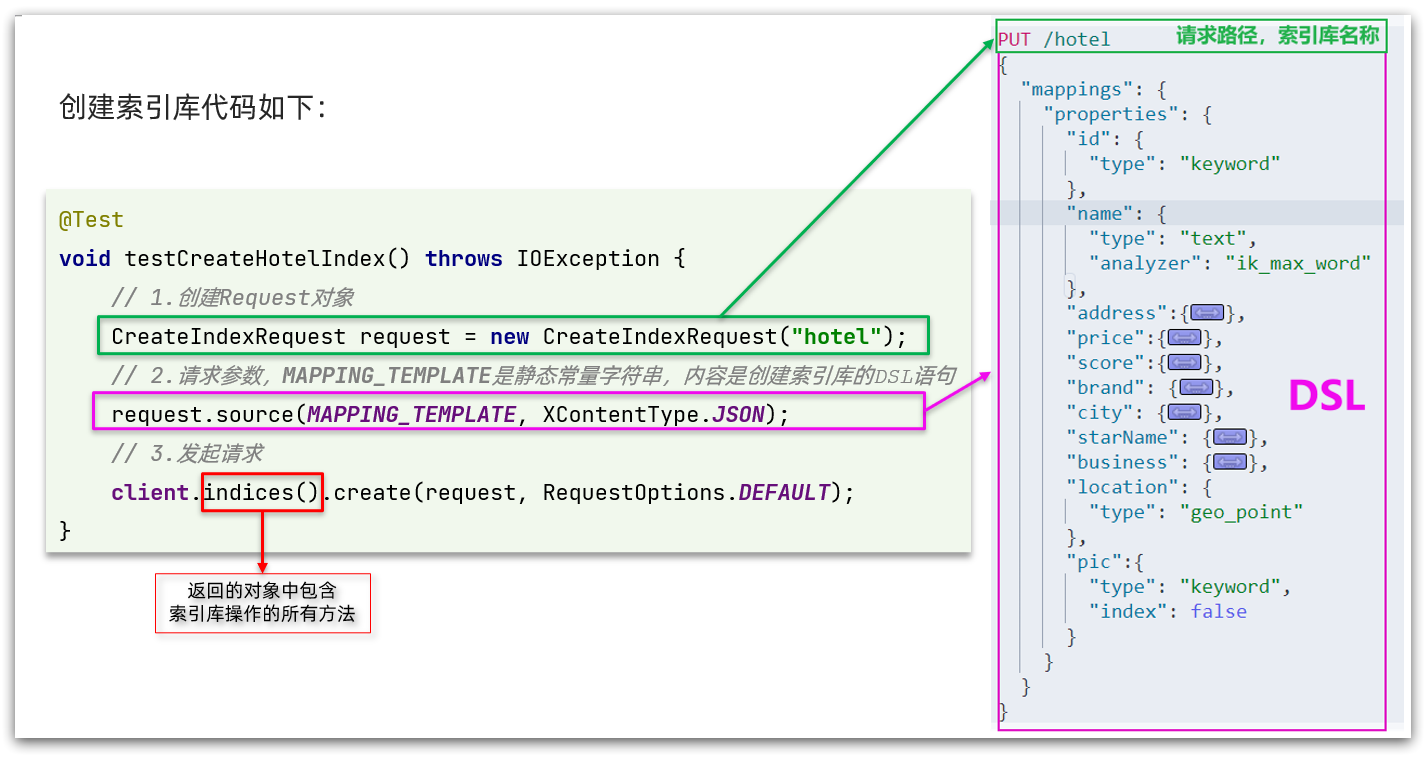
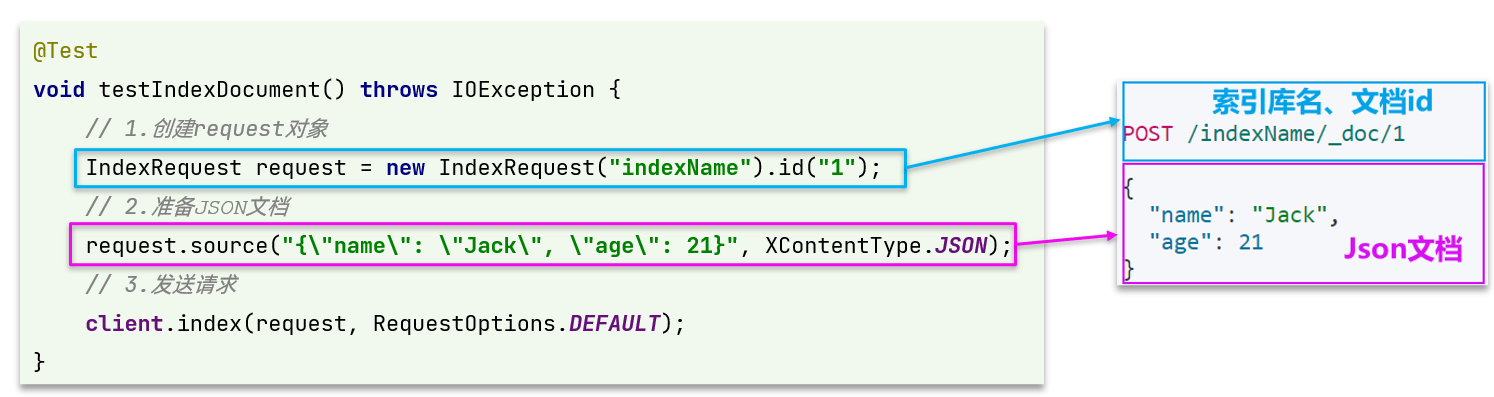
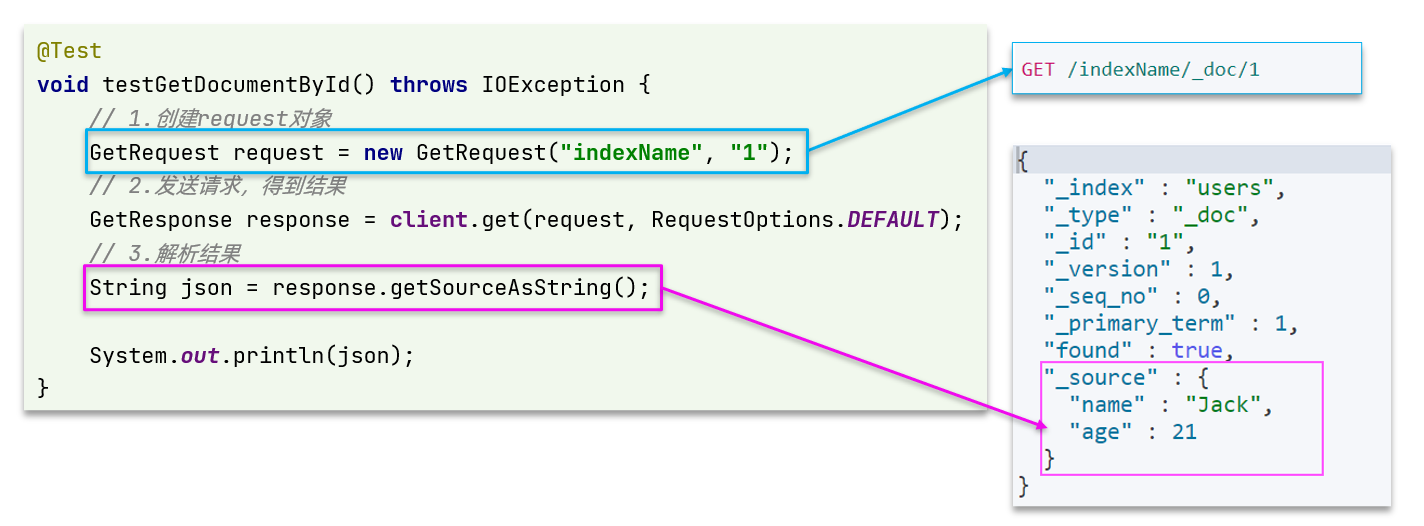
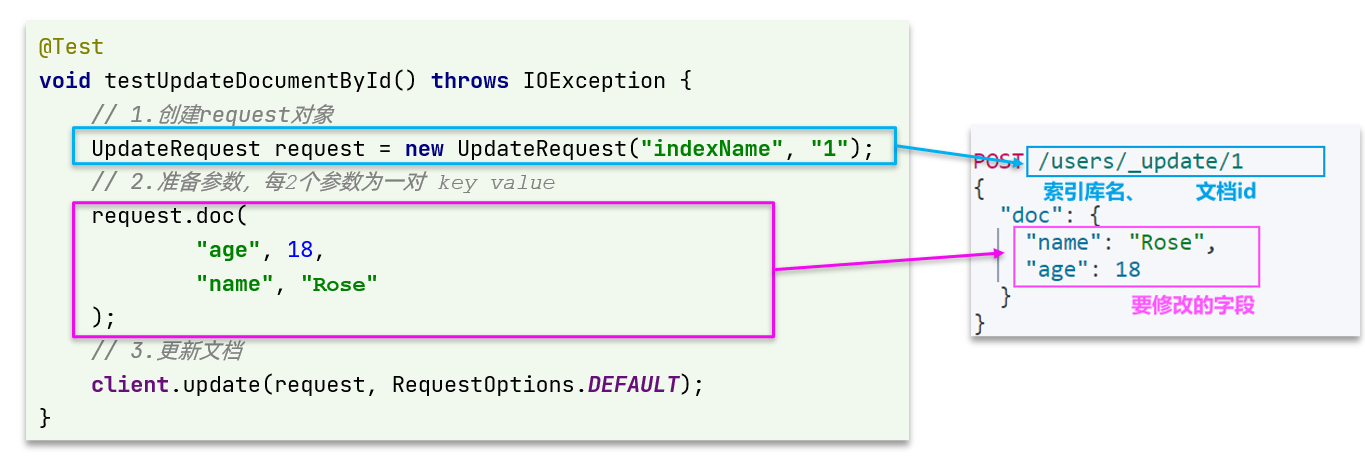
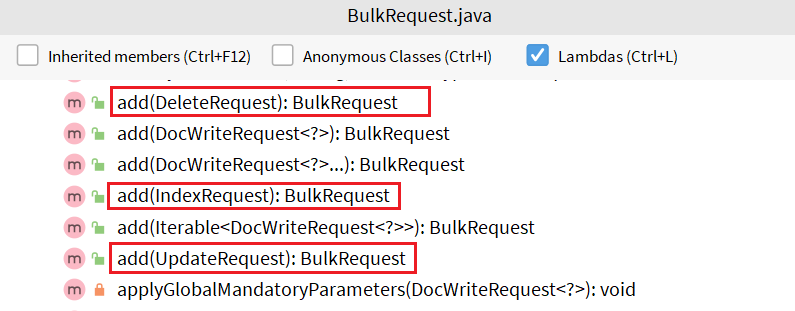

1.DSL查询文档
elasticsearch的查询依然是基于JSON风格的DSL来实现的。
1.1.DSL查询分类
Elasticsearch提供了基于JSON的DSL(Domain Specific Language)来定义查询。常见的查询类型包括:
查询所有:查询出所有数据,一般测试用。例如:match_all
全文检索(full text)查询:利用分词器对用户输入内容分词,然后去倒排索引库中匹配。例如:
- match_query
- multi_match_query
精确查询:根据精确词条值查找数据,一般是查找keyword、数值、日期、boolean等类型字段。例如:
- ids
- range
- term
地理(geo)查询:根据经纬度查询。例如:
- geo_distance
- geo_bounding_box
复合(compound)查询:复合查询可以将上述各种查询条件组合起来,合并查询条件。例如:
- bool
- function_score
查询的语法基本一致:
GET /indexName/_search
{
  "query": {
    "查询类型": {
      "查询条件": "条件值"
    }
  }
}
我们以查询所有为例,其中:
- 查询类型为match_all
- 没有查询条件
// 查询所有 GET /indexName/_search { "query": { "match_all": { } } }其它查询无非就是查询类型、查询条件的变化。
1.2.全文检索查询
1.2.1.使用场景
全文检索查询的基本流程如下:
- 对用户搜索的内容做分词,得到词条
- 根据词条去倒排索引库中匹配,得到文档id
- 根据文档id找到文档,返回给用户
比较常用的场景包括:
- 商城的输入框搜索
- 百度输入框搜索
例如京东:
因为是拿着词条去匹配,因此参与搜索的字段也必须是可分词的text类型的字段。
1.2.2.基本语法
常见的全文检索查询包括:
- match查询:单字段查询
- multi_match查询:多字段查询,任意一个字段符合条件就算符合查询条件
match查询语法如下:
GET /indexName/_search
{
  "query": {
    "match": {
      "FIELD": "TEXT"
    }
  }
}
mulit_match语法如下:
GET /indexName/_search
{
  "query": {
    "multi_match": {
      "query": "TEXT",
      "fields": ["FIELD1", " FIELD12"]
    }
  }
}
1.2.3.示例
match查询示例:
multi_match查询示例:
可以看到,两种查询结果是一样的,为什么?
因为我们将brand、name、business值都利用copy_to复制到了all字段中。因此你根据三个字段搜索,和根据all字段搜索效果当然一样了。
但是,搜索字段越多,对查询性能影响越大,因此建议采用copy_to,然后单字段查询的方式。
1.2.4.总结
match和multi_match的区别是什么?
- match:根据一个字段查询
- multi_match:根据多个字段查询,参与查询字段越多,查询性能越差
1.3.精准查询
精确查询一般是查找keyword、数值、日期、boolean等类型字段。所以不会对搜索条件分词。常见的有:
- term:根据词条精确值查询
- range:根据值的范围查询
1.3.1.term查询
因为精确查询的字段搜是不分词的字段,因此查询的条件也必须是不分词的词条。查询时,用户输入的内容跟自动值完全匹配时才认为符合条件。如果用户输入的内容过多,反而搜索不到数据。
语法说明:
// term查询
GET /indexName/_search
{
  "query": {
    "term": {
      "FIELD": {
        "value": "VALUE"
      }
    }
  }
}
示例:
当我搜索的是精确词条时,能正确查询出结果:
但是,当我搜索的内容不是词条,而是多个词语形成的短语时,反而搜索不到:
1.3.2.range查询
范围查询,一般应用在对数值类型做范围过滤的时候。比如做价格范围过滤。
基本语法:
// range查询
GET /indexName/_search
{
  "query": {
    "range": {
      "FIELD": {
        "gte": 10, // 这里的gte代表大于等于,gt则代表大于
        "lte": 20 // lte代表小于等于,lt则代表小于
      }
    }
  }
}
示例:
1.3.3.总结
精确查询常见的有哪些?
- term查询:根据词条精确匹配,一般搜索keyword类型、数值类型、布尔类型、日期类型字段
- range查询:根据数值范围查询,可以是数值、日期的范围
1.4.地理坐标查询
所谓的地理坐标查询,其实就是根据经纬度查询,官方文档:https://www.elastic.co/guide/en/elasticsearch/reference/current/geo-queries.html
常见的使用场景包括:
- 携程:搜索我附近的酒店
- 滴滴:搜索我附近的出租车
- 微信:搜索我附近的人
附近的酒店:
附近的车:
1.4.1.矩形范围查询
矩形范围查询,也就是geo_bounding_box查询,查询坐标落在某个矩形范围的所有文档:
查询时,需要指定矩形的左上、右下两个点的坐标,然后画出一个矩形,落在该矩形内的都是符合条件的点。
语法如下:
// geo_bounding_box查询
GET /indexName/_search
{
  "query": {
    "geo_bounding_box": {
      "FIELD": {
        "top_left": { // 左上点
          "lat": 31.1,
          "lon": 121.5
        },
        "bottom_right": { // 右下点
          "lat": 30.9,
          "lon": 121.7
        }
      }
    }
  }
}
这种并不符合“附近的人”这样的需求,所以我们就不做了。
1.4.2.附近查询
附近查询,也叫做距离查询(geo_distance):查询到指定中心点小于某个距离值的所有文档。
换句话来说,在地图上找一个点作为圆心,以指定距离为半径,画一个圆,落在圆内的坐标都算符合条件:
语法说明:
// geo_distance 查询
GET /indexName/_search
{
  "query": {
    "geo_distance": {
      "distance": "15km", // 半径
      "FIELD": "31.21,121.5" // 圆心
    }
  }
}
示例:
我们先搜索陆家嘴附近15km的酒店:
发现共有47家酒店。
然后把半径缩短到3公里:
可以发现,搜索到的酒店数量减少到了5家。
1.5.复合查询
复合(compound)查询:复合查询可以将其它简单查询组合起来,实现更复杂的搜索逻辑。常见的有两种:
- fuction score:算分函数查询,可以控制文档相关性算分,控制文档排名
- bool query:布尔查询,利用逻辑关系组合多个其它的查询,实现复杂搜索
1.5.1.相关性算分
当我们利用match查询时,文档结果会根据与搜索词条的关联度打分(_score),返回结果时按照分值降序排列。
例如,我们搜索 “虹桥如家”,结果如下:
[
  {
    "_score" : 17.850193,
    "_source" : {
      "name" : "虹桥如家酒店真不错",
    }
  },
  {
    "_score" : 12.259849,
    "_source" : {
      "name" : "外滩如家酒店真不错",
    }
  },
  {
    "_score" : 11.91091,
    "_source" : {
      "name" : "迪士尼如家酒店真不错",
    }
  }
]
在elasticsearch中,早期使用的打分算法是TF-IDF算法,公式如下:
在后来的5.1版本升级中,elasticsearch将算法改进为BM25算法,公式如下:
TF-IDF算法有一个缺陷,就是词条频率越高,文档得分也会越高,单个词条对文档影响较大。而BM25则会让单个词条的算分有一个上限,曲线更加平滑:
小结:elasticsearch会根据词条和文档的相关度做打分,算法由两种:
- TF-IDF算法
- BM25算法,elasticsearch5.1版本后采用的算法
1.5.2.算分函数查询
根据相关度打分是比较合理的需求,但合理的不一定是产品经理需要的。
以百度为例,你搜索的结果中,并不是相关度越高排名越靠前,而是谁掏的钱多排名就越靠前。如图:
要想认为控制相关性算分,就需要利用elasticsearch中的function score 查询了。
1)语法说明
function score 查询中包含四部分内容:
- 原始查询条件:query部分,基于这个条件搜索文档,并且基于BM25算法给文档打分,原始算分(query score)
- 过滤条件:filter部分,符合该条件的文档才会重新算分
- 算分函数:符合filter条件的文档要根据这个函数做运算,得到的函数算分(function score),有四种函数
- weight:函数结果是常量
- field_value_factor:以文档中的某个字段值作为函数结果
- random_score:以随机数作为函数结果
- script_score:自定义算分函数算法
- 运算模式:算分函数的结果、原始查询的相关性算分,两者之间的运算方式,包括:
- multiply:相乘
- replace:用function score替换query score
- 其它,例如:sum、avg、max、min
function score的运行流程如下:
- 1)根据原始条件查询搜索文档,并且计算相关性算分,称为原始算分(query score)
- 2)根据过滤条件,过滤文档
- 3)符合过滤条件的文档,基于算分函数运算,得到函数算分(function score)
- 4)将原始算分(query score)和函数算分(function score)基于运算模式做运算,得到最终结果,作为相关性算分。
因此,其中的关键点是:
- 过滤条件:决定哪些文档的算分被修改
- 算分函数:决定函数算分的算法
- 运算模式:决定最终算分结果
2)示例
需求:给“如家”这个品牌的酒店排名靠前一些
翻译一下这个需求,转换为之前说的四个要点:
- 原始条件:不确定,可以任意变化
- 过滤条件:brand = “如家”
- 算分函数:可以简单粗暴,直接给固定的算分结果,weight
- 运算模式:比如求和
因此最终的DSL语句如下:
GET /hotel/_search
{
  "query": {
    "function_score": {
      "query": {  .... }, // 原始查询,可以是任意条件
      "functions": [ // 算分函数
        {
          "filter": { // 满足的条件,品牌必须是如家
            "term": {
              "brand": "如家"
            }
          },
          "weight": 2 // 算分权重为2
        }
      ],
      "boost_mode": "sum" // 加权模式,求和
    }
  }
}
测试,在未添加算分函数时,如家得分如下:
添加了算分函数后,如家得分就提升了:
3)小结
function score query定义的三要素是什么?
- 过滤条件:哪些文档要加分
- 算分函数:如何计算function score
- 加权方式:function score 与 query score如何运算
1.5.3.布尔查询
布尔查询是一个或多个查询子句的组合,每一个子句就是一个子查询。子查询的组合方式有:
- must:必须匹配每个子查询,类似“与”
- should:选择性匹配子查询,类似“或”
- must_not:必须不匹配,不参与算分,类似“非”
- filter:必须匹配,不参与算分
比如在搜索酒店时,除了关键字搜索外,我们还可能根据品牌、价格、城市等字段做过滤:
每一个不同的字段,其查询的条件、方式都不一样,必须是多个不同的查询,而要组合这些查询,就必须用bool查询了。
需要注意的是,搜索时,参与打分的字段越多,查询的性能也越差。因此这种多条件查询时,建议这样做:
- 搜索框的关键字搜索,是全文检索查询,使用must查询,参与算分
- 其它过滤条件,采用filter查询。不参与算分
1)语法示例:
GET /hotel/_search
{
  "query": {
    "bool": {
      "must": [
        {"term": {"city": "上海" }}
      ],
      "should": [
        {"term": {"brand": "皇冠假日" }},
        {"term": {"brand": "华美达" }}
      ],
      "must_not": [
        { "range": { "price": { "lte": 500 } }}
      ],
      "filter": [
        { "range": {"score": { "gte": 45 } }}
      ]
    }
  }
}
2)示例
需求:搜索名字包含“如家”,价格不高于400,在坐标31.21,121.5周围10km范围内的酒店。
分析:
名称搜索,属于全文检索查询,应该参与算分。放到must中
价格不高于400,用range查询,属于过滤条件,不参与算分。放到must_not中
周围10km范围内,用geo_distance查询,属于过滤条件,不参与算分。放到filter中
3)小结
bool查询有几种逻辑关系?
- must:必须匹配的条件,可以理解为“与”
- should:选择性匹配的条件,可以理解为“或”
- must_not:必须不匹配的条件,不参与打分
- filter:必须匹配的条件,不参与打分
2.搜索结果处理
搜索的结果可以按照用户指定的方式去处理或展示。
2.1.排序
elasticsearch默认是根据相关度算分(_score)来排序,但是也支持自定义方式对搜索结果排序。可以排序字段类型有:keyword类型、数值类型、地理坐标类型、日期类型等。
2.1.1.普通字段排序
keyword、数值、日期类型排序的语法基本一致。
语法:
GET /indexName/_search
{
  "query": {
    "match_all": {}
  },
  "sort": [
    {
      "FIELD": "desc"  // 排序字段、排序方式ASC、DESC
    }
  ]
}
排序条件是一个数组,也就是可以写多个排序条件。按照声明的顺序,当第一个条件相等时,再按照第二个条件排序,以此类推
示例:
需求描述:酒店数据按照用户评价(score)降序排序,评价相同的按照价格(price)升序排序
2.1.2.地理坐标排序
地理坐标排序略有不同。
语法说明:
GET /indexName/_search
{
  "query": {
    "match_all": {}
  },
  "sort": [
    {
      "_geo_distance" : {
          "FIELD" : "纬度,经度", // 文档中geo_point类型的字段名、目标坐标点
          "order" : "asc", // 排序方式
          "unit" : "km" // 排序的距离单位
      }
    }
  ]
}
这个查询的含义是:
- 指定一个坐标,作为目标点
- 计算每一个文档中,指定字段(必须是geo_point类型)的坐标 到目标点的距离是多少
- 根据距离排序
示例:
需求描述:实现对酒店数据按照到你的位置坐标的距离升序排序
提示:获取你的位置的经纬度的方式:https://lbs.amap.com/demo/jsapi-v2/example/map/click-to-get-lnglat/
假设我的位置是:31.034661,121.612282,寻找我周围距离最近的酒店。
2.2.分页
elasticsearch 默认情况下只返回top10的数据。而如果要查询更多数据就需要修改分页参数了。elasticsearch中通过修改from、size参数来控制要返回的分页结果:
- from:从第几个文档开始
- size:总共查询几个文档
类似于mysql中的
limit ?, ?2.2.1.基本的分页
分页的基本语法如下:
GET /hotel/_search
{
  "query": {
    "match_all": {}
  },
  "from": 0, // 分页开始的位置,默认为0
  "size": 10, // 期望获取的文档总数
  "sort": [
    {"price": "asc"}
  ]
}
2.2.2.深度分页问题
现在,我要查询990~1000的数据,查询逻辑要这么写:
GET /hotel/_search
{
  "query": {
    "match_all": {}
  },
  "from": 990, // 分页开始的位置,默认为0
  "size": 10, // 期望获取的文档总数
  "sort": [
    {"price": "asc"}
  ]
}
这里是查询990开始的数据,也就是 第990~第1000条 数据。
不过,elasticsearch内部分页时,必须先查询 0~1000条,然后截取其中的990 ~ 1000的这10条:
查询TOP1000,如果es是单点模式,这并无太大影响。
但是elasticsearch将来一定是集群,例如我集群有5个节点,我要查询TOP1000的数据,并不是每个节点查询200条就可以了。
因为节点A的TOP200,在另一个节点可能排到10000名以外了。
因此要想获取整个集群的TOP1000,必须先查询出每个节点的TOP1000,汇总结果后,重新排名,重新截取TOP1000。
那如果我要查询9900~10000的数据呢?是不是要先查询TOP10000呢?那每个节点都要查询10000条?汇总到内存中?
当查询分页深度较大时,汇总数据过多,对内存和CPU会产生非常大的压力,因此elasticsearch会禁止from+ size 超过10000的请求。
针对深度分页,ES提供了两种解决方案,官方文档:
- search after:分页时需要排序,原理是从上一次的排序值开始,查询下一页数据。官方推荐使用的方式。
- scroll:原理将排序后的文档id形成快照,保存在内存。官方已经不推荐使用。
2.2.3.小结
分页查询的常见实现方案以及优缺点:
from + size:
- 优点:支持随机翻页
- 缺点:深度分页问题,默认查询上限(from + size)是10000
- 场景:百度、京东、谷歌、淘宝这样的随机翻页搜索
after search:
- 优点:没有查询上限(单次查询的size不超过10000)
- 缺点:只能向后逐页查询,不支持随机翻页
- 场景:没有随机翻页需求的搜索,例如手机向下滚动翻页
scroll:
- 优点:没有查询上限(单次查询的size不超过10000)
- 缺点:会有额外内存消耗,并且搜索结果是非实时的
- 场景:海量数据的获取和迁移。从ES7.1开始不推荐,建议用 after search方案。
2.3.高亮
2.3.1.高亮原理
什么是高亮显示呢?
我们在百度,京东搜索时,关键字会变成红色,比较醒目,这叫高亮显示:
高亮显示的实现分为两步:
- 1)给文档中的所有关键字都添加一个标签,例如
<em>标签- 2)页面给
<em>标签编写CSS样式2.3.2.实现高亮
高亮的语法:
GET /hotel/_search
{
  "query": {
    "match": {
      "FIELD": "TEXT" // 查询条件,高亮一定要使用全文检索查询
    }
  },
  "highlight": {
    "fields": { // 指定要高亮的字段
      "FIELD": {
        "pre_tags": "<em>",  // 用来标记高亮字段的前置标签
        "post_tags": "</em>" // 用来标记高亮字段的后置标签
      }
    }
  }
}
注意:
- 高亮是对关键字高亮,因此搜索条件必须带有关键字,而不能是范围这样的查询。
- 默认情况下,高亮的字段,必须与搜索指定的字段一致,否则无法高亮
- 如果要对非搜索字段高亮,则需要添加一个属性:required_field_match=false
示例:
2.4.总结
查询的DSL是一个大的JSON对象,包含下列属性:
- query:查询条件
- from和size:分页条件
- sort:排序条件
- highlight:高亮条件
示例:
3.RestClient查询文档
文档的查询同样适用昨天学习的 RestHighLevelClient对象,基本步骤包括:
- 1)准备Request对象
- 2)准备请求参数
- 3)发起请求
- 4)解析响应
3.1.快速入门
我们以match_all查询为例
3.1.1.发起查询请求
代码解读:
第一步,创建
SearchRequest对象,指定索引库名第二步,利用
request.source()构建DSL,DSL中可以包含查询、分页、排序、高亮等
query():代表查询条件,利用QueryBuilders.matchAllQuery()构建一个match_all查询的DSL第三步,利用client.search()发送请求,得到响应
这里关键的API有两个,一个是
request.source(),其中包含了查询、排序、分页、高亮等所有功能:另一个是
QueryBuilders,其中包含match、term、function_score、bool等各种查询:3.1.2.解析响应
响应结果的解析:
elasticsearch返回的结果是一个JSON字符串,结构包含:
hits:命中的结果
total:总条数,其中的value是具体的总条数值max_score:所有结果中得分最高的文档的相关性算分hits:搜索结果的文档数组,其中的每个文档都是一个json对象
_source:文档中的原始数据,也是json对象因此,我们解析响应结果,就是逐层解析JSON字符串,流程如下:
SearchHits:通过response.getHits()获取,就是JSON中的最外层的hits,代表命中的结果
SearchHits#getTotalHits().value:获取总条数信息SearchHits#getHits():获取SearchHit数组,也就是文档数组
SearchHit#getSourceAsString():获取文档结果中的_source,也就是原始的json文档数据3.1.3.完整代码
完整代码如下:
@Test
void testMatchAll() throws IOException {
    // 1.准备Request
    SearchRequest request = new SearchRequest("hotel");
    // 2.准备DSL
    request.source()
        .query(QueryBuilders.matchAllQuery());
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);

    // 4.解析响应
    handleResponse(response);
}

private void handleResponse(SearchResponse response) {
    // 4.解析响应
    SearchHits searchHits = response.getHits();
    // 4.1.获取总条数
    long total = searchHits.getTotalHits().value;
    System.out.println("共搜索到" + total + "条数据");
    // 4.2.文档数组
    SearchHit[] hits = searchHits.getHits();
    // 4.3.遍历
    for (SearchHit hit : hits) {
        // 获取文档source
        String json = hit.getSourceAsString();
        // 反序列化
        HotelDoc hotelDoc = JSON.parseObject(json, HotelDoc.class);
        System.out.println("hotelDoc = " + hotelDoc);
    }
}
3.1.4.小结
查询的基本步骤是:
创建SearchRequest对象
准备Request.source(),也就是DSL。
① QueryBuilders来构建查询条件
② 传入Request.source() 的 query() 方法
发送请求,得到结果
解析结果(参考JSON结果,从外到内,逐层解析)
3.2.match查询
全文检索的match和multi_match查询与match_all的API基本一致。差别是查询条件,也就是query的部分。
因此,Java代码上的差异主要是request.source().query()中的参数了。同样是利用QueryBuilders提供的方法:
而结果解析代码则完全一致,可以抽取并共享。
完整代码如下:
@Test
void testMatch() throws IOException {
    // 1.准备Request
    SearchRequest request = new SearchRequest("hotel");
    // 2.准备DSL
    request.source()
        .query(QueryBuilders.matchQuery("all", "如家"));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);

}
3.3.精确查询
精确查询主要是两者:
- term:词条精确匹配
- range:范围查询
与之前的查询相比,差异同样在查询条件,其它都一样。
查询条件构造的API如下:
3.4.布尔查询
布尔查询是用must、must_not、filter等方式组合其它查询,代码示例如下:
可以看到,API与其它查询的差别同样是在查询条件的构建,QueryBuilders,结果解析等其他代码完全不变。
完整代码如下:
@Test
void testBool() throws IOException {
    // 1.准备Request
    SearchRequest request = new SearchRequest("hotel");
    // 2.准备DSL
    // 2.1.准备BooleanQuery
    BoolQueryBuilder boolQuery = QueryBuilders.boolQuery();
    // 2.2.添加term
    boolQuery.must(QueryBuilders.termQuery("city", "杭州"));
    // 2.3.添加range
    boolQuery.filter(QueryBuilders.rangeQuery("price").lte(250));

    request.source().query(boolQuery);
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);

}
3.5.排序、分页
搜索结果的排序和分页是与query同级的参数,因此同样是使用request.source()来设置。
对应的API如下:
完整代码示例:
@Test
void testPageAndSort() throws IOException {
    // 页码,每页大小
    int page = 1, size = 5;

    // 1.准备Request
    SearchRequest request = new SearchRequest("hotel");
    // 2.准备DSL
    // 2.1.query
    request.source().query(QueryBuilders.matchAllQuery());
    // 2.2.排序 sort
    request.source().sort("price", SortOrder.ASC);
    // 2.3.分页 from、size
    request.source().from((page - 1) * size).size(5);
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);

}
3.6.高亮
高亮的代码与之前代码差异较大,有两点:
- 查询的DSL:其中除了查询条件,还需要添加高亮条件,同样是与query同级。
- 结果解析:结果除了要解析_source文档数据,还要解析高亮结果
3.6.1.高亮请求构建
高亮请求的构建API如下:
上述代码省略了查询条件部分,但是大家不要忘了:高亮查询必须使用全文检索查询,并且要有搜索关键字,将来才可以对关键字高亮。
完整代码如下:
@Test
void testHighlight() throws IOException {
    // 1.准备Request
    SearchRequest request = new SearchRequest("hotel");
    // 2.准备DSL
    // 2.1.query
    request.source().query(QueryBuilders.matchQuery("all", "如家"));
    // 2.2.高亮
    request.source().highlighter(new HighlightBuilder().field("name").requireFieldMatch(false));
    // 3.发送请求
    SearchResponse response = client.search(request, RequestOptions.DEFAULT);
    // 4.解析响应
    handleResponse(response);

}
3.6.2.高亮结果解析
高亮的结果与查询的文档结果默认是分离的,并不在一起。
因此解析高亮的代码需要额外处理:
代码解读:
- 第一步:从结果中获取source。hit.getSourceAsString(),这部分是非高亮结果,json字符串。还需要反序列为HotelDoc对象
- 第二步:获取高亮结果。hit.getHighlightFields(),返回值是一个Map,key是高亮字段名称,值是HighlightField对象,代表高亮值
- 第三步:从map中根据高亮字段名称,获取高亮字段值对象HighlightField
- 第四步:从HighlightField中获取Fragments,并且转为字符串。这部分就是真正的高亮字符串了
- 第五步:用高亮的结果替换HotelDoc中的非高亮结果
完整代码如下:
private void handleResponse(SearchResponse response) {
    // 4.解析响应
    SearchHits searchHits = response.getHits();
    // 4.1.获取总条数
    long total = searchHits.getTotalHits().value;
    System.out.println("共搜索到" + total + "条数据");
    // 4.2.文档数组
    SearchHit[] hits = searchHits.getHits();
    // 4.3.遍历
    for (SearchHit hit : hits) {
        // 获取文档source
        String json = hit.getSourceAsString();
        // 反序列化
        HotelDoc hotelDoc = JSON.parseObject(json, HotelDoc.class);
        // 获取高亮结果
        Map<String, HighlightField> highlightFields = hit.getHighlightFields();
        if (!CollectionUtils.isEmpty(highlightFields)) {
            // 根据字段名获取高亮结果
            HighlightField highlightField = highlightFields.get("name");
            if (highlightField != null) {
                // 获取高亮值
                String name = highlightField.getFragments()[0].string();
                // 覆盖非高亮结果
                hotelDoc.setName(name);
            }
        }
        System.out.println("hotelDoc = " + hotelDoc);
    }
}
4.黑马旅游案例
下面,我们通过黑马旅游的案例来实战演练下之前学习的知识。
我们实现四部分功能:
- 酒店搜索和分页
- 酒店结果过滤
- 我周边的酒店
- 酒店竞价排名
启动我们提供的hotel-demo项目,其默认端口是8089,访问http://localhost:8090,就能看到项目页面了:
4.1.酒店搜索和分页
案例需求:实现黑马旅游的酒店搜索功能,完成关键字搜索和分页
4.1.1.需求分析
在项目的首页,有一个大大的搜索框,还有分页按钮:
点击搜索按钮,可以看到浏览器控制台发出了请求:
请求参数如下:
由此可以知道,我们这个请求的信息如下:
- 请求方式:POST
- 请求路径:/hotel/list
- 请求参数:JSON对象,包含4个字段:
- key:搜索关键字
- page:页码
- size:每页大小
- sortBy:排序,目前暂不实现
- 返回值:分页查询,需要返回分页结果PageResult,包含两个属性:
total:总条数List<HotelDoc>:当前页的数据因此,我们实现业务的流程如下:
- 步骤一:定义实体类,接收请求参数的JSON对象
- 步骤二:编写controller,接收页面的请求
- 步骤三:编写业务实现,利用RestHighLevelClient实现搜索、分页
4.1.2.定义实体类
实体类有两个,一个是前端的请求参数实体,一个是服务端应该返回的响应结果实体。
1)请求参数
前端请求的json结构如下:
{
    "key": "搜索关键字",
    "page": 1,
    "size": 3,
    "sortBy": "default"
}
因此,我们在
cn.itcast.hotel.pojo包下定义一个实体类:package cn.itcast.hotel.pojo; import lombok.Data; @Data public class RequestParams { private String key; private Integer page; private Integer size; private String sortBy; }2)返回值
分页查询,需要返回分页结果PageResult,包含两个属性:
total:总条数List<HotelDoc>:当前页的数据因此,我们在
cn.itcast.hotel.pojo中定义返回结果:package cn.itcast.hotel.pojo; import lombok.Data; import java.util.List; @Data public class PageResult { private Long total; private List<HotelDoc> hotels; public PageResult() { } public PageResult(Long total, List<HotelDoc> hotels) { this.total = total; this.hotels = hotels; } }4.1.3.定义controller
定义一个HotelController,声明查询接口,满足下列要求:
- 请求方式:Post
- 请求路径:/hotel/list
- 请求参数:对象,类型为RequestParam
- 返回值:PageResult,包含两个属性
Long total:总条数List<HotelDoc> hotels:酒店数据因此,我们在
cn.itcast.hotel.web中定义HotelController:@RestController @RequestMapping("/hotel") public class HotelController { @Autowired private IHotelService hotelService; // 搜索酒店数据 @PostMapping("/list") public PageResult search(@RequestBody RequestParams params){ return hotelService.search(params); } }4.1.4.实现搜索业务
我们在controller调用了IHotelService,并没有实现该方法,因此下面我们就在IHotelService中定义方法,并且去实现业务逻辑。
1)在
cn.itcast.hotel.service中的IHotelService接口中定义一个方法:/** * 根据关键字搜索酒店信息 * @param params 请求参数对象,包含用户输入的关键字 * @return 酒店文档列表 */ PageResult search(RequestParams params);2)实现搜索业务,肯定离不开RestHighLevelClient,我们需要把它注册到Spring中作为一个Bean。在
cn.itcast.hotel中的HotelDemoApplication中声明这个Bean:@Bean public RestHighLevelClient client(){ return new RestHighLevelClient(RestClient.builder( HttpHost.create("http://192.168.150.101:9200") )); }3)在
cn.itcast.hotel.service.impl中的HotelService中实现search方法:@Override public PageResult search(RequestParams params) { try { // 1.准备Request SearchRequest request = new SearchRequest("hotel"); // 2.准备DSL // 2.1.query String key = params.getKey(); if (key == null || "".equals(key)) { boolQuery.must(QueryBuilders.matchAllQuery()); } else { boolQuery.must(QueryBuilders.matchQuery("all", key)); } // 2.2.分页 int page = params.getPage(); int size = params.getSize(); request.source().from((page - 1) * size).size(size); request.source().query(boolQuery); // 3.发送请求 SearchResponse response = client.search(request, RequestOptions.DEFAULT); // 4.解析响应 return handleResponse(response); } catch (IOException e) { throw new RuntimeException(e); } } // 结果解析 private PageResult handleResponse(SearchResponse response) { // 4.解析响应 SearchHits searchHits = response.getHits(); // 4.1.获取总条数 long total = searchHits.getTotalHits().value; // 4.2.文档数组 SearchHit[] hits = searchHits.getHits(); // 4.3.遍历 List<HotelDoc> hotels = new ArrayList<>(); for (SearchHit hit : hits) { // 获取文档source String json = hit.getSourceAsString(); // 反序列化 HotelDoc hotelDoc = JSON.parseObject(json, HotelDoc.class); // 放入集合 hotels.add(hotelDoc); } // 4.4.封装返回 return new PageResult(total, hotels); }4.2.酒店结果过滤
需求:添加品牌、城市、星级、价格等过滤功能
4.2.1.需求分析
在页面搜索框下面,会有一些过滤项:
传递的参数如图:
包含的过滤条件有:
- brand:品牌值
- city:城市
- minPrice~maxPrice:价格范围
- starName:星级
我们需要做两件事情:
- 修改请求参数的对象RequestParams,接收上述参数
- 修改业务逻辑,在搜索条件之外,添加一些过滤条件
4.2.2.修改实体类
修改在
cn.itcast.hotel.pojo包下的实体类RequestParams:@Data public class RequestParams { private String key; private Integer page; private Integer size; private String sortBy; // 下面是新增的过滤条件参数 private String city; private String brand; private String starName; private Integer minPrice; private Integer maxPrice; }4.2.3.修改搜索业务
在HotelService的search方法中,只有一个地方需要修改:requet.source().query( … )其中的查询条件。
在之前的业务中,只有match查询,根据关键字搜索,现在要添加条件过滤,包括:
- 品牌过滤:是keyword类型,用term查询
- 星级过滤:是keyword类型,用term查询
- 价格过滤:是数值类型,用range查询
- 城市过滤:是keyword类型,用term查询
多个查询条件组合,肯定是boolean查询来组合:
- 关键字搜索放到must中,参与算分
- 其它过滤条件放到filter中,不参与算分
因为条件构建的逻辑比较复杂,这里先封装为一个函数:
buildBasicQuery的代码如下:
private void buildBasicQuery(RequestParams params, SearchRequest request) {
    // 1.构建BooleanQuery
    BoolQueryBuilder boolQuery = QueryBuilders.boolQuery();
    // 2.关键字搜索
    String key = params.getKey();
    if (key == null || "".equals(key)) {
        boolQuery.must(QueryBuilders.matchAllQuery());
    } else {
        boolQuery.must(QueryBuilders.matchQuery("all", key));
    }
    // 3.城市条件
    if (params.getCity() != null && !params.getCity().equals("")) {
        boolQuery.filter(QueryBuilders.termQuery("city", params.getCity()));
    }
    // 4.品牌条件
    if (params.getBrand() != null && !params.getBrand().equals("")) {
        boolQuery.filter(QueryBuilders.termQuery("brand", params.getBrand()));
    }
    // 5.星级条件
    if (params.getStarName() != null && !params.getStarName().equals("")) {
        boolQuery.filter(QueryBuilders.termQuery("starName", params.getStarName()));
    }
	// 6.价格
    if (params.getMinPrice() != null && params.getMaxPrice() != null) {
        boolQuery.filter(QueryBuilders
                         .rangeQuery("price")
                         .gte(params.getMinPrice())
                         .lte(params.getMaxPrice())
                        );
    }
	// 7.放入source
    request.source().query(boolQuery);
}
4.3.我周边的酒店
需求:我附近的酒店
4.3.1.需求分析
在酒店列表页的右侧,有一个小地图,点击地图的定位按钮,地图会找到你所在的位置:
并且,在前端会发起查询请求,将你的坐标发送到服务端:
我们要做的事情就是基于这个location坐标,然后按照距离对周围酒店排序。实现思路如下:
- 修改RequestParams参数,接收location字段
- 修改search方法业务逻辑,如果location有值,添加根据geo_distance排序的功能
4.3.2.修改实体类
修改在
cn.itcast.hotel.pojo包下的实体类RequestParams:package cn.itcast.hotel.pojo; import lombok.Data; @Data public class RequestParams { private String key; private Integer page; private Integer size; private String sortBy; private String city; private String brand; private String starName; private Integer minPrice; private Integer maxPrice; // 我当前的地理坐标 private String location; }4.3.3.距离排序API
我们以前学习过排序功能,包括两种:
- 普通字段排序
- 地理坐标排序
我们只讲了普通字段排序对应的java写法。地理坐标排序只学过DSL语法,如下:
GET /indexName/_search
{
  "query": {
    "match_all": {}
  },
  "sort": [
    {
      "price": "asc"
    },
    {
      "_geo_distance" : {
          "FIELD" : "纬度,经度",
          "order" : "asc",
          "unit" : "km"
      }
    }
  ]
}
对应的java代码示例:
4.3.4.添加距离排序
在
cn.itcast.hotel.service.impl的HotelService的search方法中,添加一个排序功能:完整代码:
@Override
public PageResult search(RequestParams params) {
    try {
        // 1.准备Request
        SearchRequest request = new SearchRequest("hotel");
        // 2.准备DSL
        // 2.1.query
        buildBasicQuery(params, request);

        // 2.2.分页
        int page = params.getPage();
        int size = params.getSize();
        request.source().from((page - 1) * size).size(size);

        // 2.3.排序
        String location = params.getLocation();
        if (location != null && !location.equals("")) {
            request.source().sort(SortBuilders
                                  .geoDistanceSort("location", new GeoPoint(location))
                                  .order(SortOrder.ASC)
                                  .unit(DistanceUnit.KILOMETERS)
                                 );
        }

        // 3.发送请求
        SearchResponse response = client.search(request, RequestOptions.DEFAULT);
        // 4.解析响应
        return handleResponse(response);
    } catch (IOException e) {
        throw new RuntimeException(e);
    }
}
4.3.5.排序距离显示
重启服务后,测试我的酒店功能:
发现确实可以实现对我附近酒店的排序,不过并没有看到酒店到底距离我多远,这该怎么办?
排序完成后,页面还要获取我附近每个酒店的具体距离值,这个值在响应结果中是独立的:
因此,我们在结果解析阶段,除了解析source部分以外,还要得到sort部分,也就是排序的距离,然后放到响应结果中。
我们要做两件事:
- 修改HotelDoc,添加排序距离字段,用于页面显示
- 修改HotelService类中的handleResponse方法,添加对sort值的获取
1)修改HotelDoc类,添加距离字段
package cn.itcast.hotel.pojo;

import lombok.Data;
import lombok.NoArgsConstructor;


@Data
@NoArgsConstructor
public class HotelDoc {
    private Long id;
    private String name;
    private String address;
    private Integer price;
    private Integer score;
    private String brand;
    private String city;
    private String starName;
    private String business;
    private String location;
    private String pic;
    // 排序时的 距离值
    private Object distance;

    public HotelDoc(Hotel hotel) {
        this.id = hotel.getId();
        this.name = hotel.getName();
        this.address = hotel.getAddress();
        this.price = hotel.getPrice();
        this.score = hotel.getScore();
        this.brand = hotel.getBrand();
        this.city = hotel.getCity();
        this.starName = hotel.getStarName();
        this.business = hotel.getBusiness();
        this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
        this.pic = hotel.getPic();
    }
}
2)修改HotelService中的handleResponse方法
重启后测试,发现页面能成功显示距离了:
4.4.酒店竞价排名
需求:让指定的酒店在搜索结果中排名置顶
4.4.1.需求分析
要让指定酒店在搜索结果中排名置顶,效果如图:
页面会给指定的酒店添加广告标记。
那怎样才能让指定的酒店排名置顶呢?
我们之前学习过的function_score查询可以影响算分,算分高了,自然排名也就高了。而function_score包含3个要素:
- 过滤条件:哪些文档要加分
- 算分函数:如何计算function score
- 加权方式:function score 与 query score如何运算
这里的需求是:让指定酒店排名靠前。因此我们需要给这些酒店添加一个标记,这样在过滤条件中就可以根据这个标记来判断,是否要提高算分。
比如,我们给酒店添加一个字段:isAD,Boolean类型:
- true:是广告
- false:不是广告
这样function_score包含3个要素就很好确定了:
- 过滤条件:判断isAD 是否为true
- 算分函数:我们可以用最简单暴力的weight,固定加权值
- 加权方式:可以用默认的相乘,大大提高算分
因此,业务的实现步骤包括:
- 给HotelDoc类添加isAD字段,Boolean类型
- 挑选几个你喜欢的酒店,给它的文档数据添加isAD字段,值为true
- 修改search方法,添加function score功能,给isAD值为true的酒店增加权重
4.4.2.修改HotelDoc实体
给
cn.itcast.hotel.pojo包下的HotelDoc类添加isAD字段:4.4.3.添加广告标记
接下来,我们挑几个酒店,添加isAD字段,设置为true:
POST /hotel/_update/1902197537
{
    "doc": {
        "isAD": true
    }
}
POST /hotel/_update/2056126831
{
    "doc": {
        "isAD": true
    }
}
POST /hotel/_update/1989806195
{
    "doc": {
        "isAD": true
    }
}
POST /hotel/_update/2056105938
{
    "doc": {
        "isAD": true
    }
}
4.4.4.添加算分函数查询
接下来我们就要修改查询条件了。之前是用的boolean 查询,现在要改成function_socre查询。
function_score查询结构如下:
对应的JavaAPI如下:
我们可以将之前写的boolean查询作为原始查询条件放到query中,接下来就是添加过滤条件、算分函数、加权模式了。所以原来的代码依然可以沿用。
修改
cn.itcast.hotel.service.impl包下的HotelService类中的buildBasicQuery方法,添加算分函数查询:private void buildBasicQuery(RequestParams params, SearchRequest request) { // 1.构建BooleanQuery BoolQueryBuilder boolQuery = QueryBuilders.boolQuery(); // 关键字搜索 String key = params.getKey(); if (key == null || "".equals(key)) { boolQuery.must(QueryBuilders.matchAllQuery()); } else { boolQuery.must(QueryBuilders.matchQuery("all", key)); } // 城市条件 if (params.getCity() != null && !params.getCity().equals("")) { boolQuery.filter(QueryBuilders.termQuery("city", params.getCity())); } // 品牌条件 if (params.getBrand() != null && !params.getBrand().equals("")) { boolQuery.filter(QueryBuilders.termQuery("brand", params.getBrand())); } // 星级条件 if (params.getStarName() != null && !params.getStarName().equals("")) { boolQuery.filter(QueryBuilders.termQuery("starName", params.getStarName())); } // 价格 if (params.getMinPrice() != null && params.getMaxPrice() != null) { boolQuery.filter(QueryBuilders .rangeQuery("price") .gte(params.getMinPrice()) .lte(params.getMaxPrice()) ); } // 2.算分控制 FunctionScoreQueryBuilder functionScoreQuery = QueryBuilders.functionScoreQuery( // 原始查询,相关性算分的查询 boolQuery, // function score的数组 new FunctionScoreQueryBuilder.FilterFunctionBuilder[]{ // 其中的一个function score 元素 new FunctionScoreQueryBuilder.FilterFunctionBuilder( // 过滤条件 QueryBuilders.termQuery("isAD", true), // 算分函数 ScoreFunctionBuilders.weightFactorFunction(10) ) }); request.source().query(functionScoreQuery); }


1.数据聚合
**聚合(aggregations)**可以让我们极其方便的实现对数据的统计、分析、运算。例如:
- 什么品牌的手机最受欢迎?
- 这些手机的平均价格、最高价格、最低价格?
- 这些手机每月的销售情况如何?
实现这些统计功能的比数据库的sql要方便的多,而且查询速度非常快,可以实现近实时搜索效果。
1.1.聚合的种类
聚合常见的有三类:
**桶(Bucket)**聚合:用来对文档做分组
- TermAggregation:按照文档字段值分组,例如按照品牌值分组、按照国家分组
- Date Histogram:按照日期阶梯分组,例如一周为一组,或者一月为一组
**度量(Metric)**聚合:用以计算一些值,比如:最大值、最小值、平均值等
- Avg:求平均值
- Max:求最大值
- Min:求最小值
- Stats:同时求max、min、avg、sum等
**管道(pipeline)**聚合:其它聚合的结果为基础做聚合
**注意:**参加聚合的字段必须是keyword、日期、数值、布尔类型
1.2.DSL实现聚合
现在,我们要统计所有数据中的酒店品牌有几种,其实就是按照品牌对数据分组。此时可以根据酒店品牌的名称做聚合,也就是Bucket聚合。
1.2.1.Bucket聚合语法
语法如下:
GET /hotel/_search
{
  "size": 0,  // 设置size为0,结果中不包含文档,只包含聚合结果
  "aggs": { // 定义聚合
    "brandAgg": { //给聚合起个名字
      "terms": { // 聚合的类型,按照品牌值聚合,所以选择term
        "field": "brand", // 参与聚合的字段
        "size": 20 // 希望获取的聚合结果数量
      }
    }
  }
}
结果如图:
1.2.2.聚合结果排序
默认情况下,Bucket聚合会统计Bucket内的文档数量,记为_count,并且按照_count降序排序。
我们可以指定order属性,自定义聚合的排序方式:
GET /hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "order": {
          "_count": "asc" // 按照_count升序排列
        },
        "size": 20
      }
    }
  }
}
1.2.3.限定聚合范围
默认情况下,Bucket聚合是对索引库的所有文档做聚合,但真实场景下,用户会输入搜索条件,因此聚合必须是对搜索结果聚合。那么聚合必须添加限定条件。
我们可以限定要聚合的文档范围,只要添加query条件即可:
GET /hotel/_search
{
  "query": {
    "range": {
      "price": {
        "lte": 200 // 只对200元以下的文档聚合
      }
    }
  },
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20
      }
    }
  }
}
这次,聚合得到的品牌明显变少了:
1.2.4.Metric聚合语法
上节课,我们对酒店按照品牌分组,形成了一个个桶。现在我们需要对桶内的酒店做运算,获取每个品牌的用户评分的min、max、avg等值。
这就要用到Metric聚合了,例如stat聚合:就可以获取min、max、avg等结果。
语法如下:
GET /hotel/_search
{
  "size": 0,
  "aggs": {
    "brandAgg": {
      "terms": {
        "field": "brand",
        "size": 20
      },
      "aggs": { // 是brands聚合的子聚合,也就是分组后对每组分别计算
        "score_stats": { // 聚合名称
          "stats": { // 聚合类型,这里stats可以计算min、max、avg等
            "field": "score" // 聚合字段,这里是score
          }
        }
      }
    }
  }
}
这次的score_stats聚合是在brandAgg的聚合内部嵌套的子聚合。因为我们需要在每个桶分别计算。
另外,我们还可以给聚合结果做个排序,例如按照每个桶的酒店平均分做排序:
1.2.5.小结
aggs代表聚合,与query同级,此时query的作用是?
- 限定聚合的的文档范围
聚合必须的三要素:
- 聚合名称
- 聚合类型
- 聚合字段
聚合可配置属性有:
- size:指定聚合结果数量
- order:指定聚合结果排序方式
- field:指定聚合字段
1.3.RestAPI实现聚合
1.3.1.API语法
聚合条件与query条件同级别,因此需要使用request.source()来指定聚合条件。
聚合条件的语法:
聚合的结果也与查询结果不同,API也比较特殊。不过同样是JSON逐层解析:
1.3.2.业务需求
需求:搜索页面的品牌、城市等信息不应该是在页面写死,而是通过聚合索引库中的酒店数据得来的:
分析:
目前,页面的城市列表、星级列表、品牌列表都是写死的,并不会随着搜索结果的变化而变化。但是用户搜索条件改变时,搜索结果会跟着变化。
例如:用户搜索“东方明珠”,那搜索的酒店肯定是在上海东方明珠附近,因此,城市只能是上海,此时城市列表中就不应该显示北京、深圳、杭州这些信息了。
也就是说,搜索结果中包含哪些城市,页面就应该列出哪些城市;搜索结果中包含哪些品牌,页面就应该列出哪些品牌。
如何得知搜索结果中包含哪些品牌?如何得知搜索结果中包含哪些城市?
使用聚合功能,利用Bucket聚合,对搜索结果中的文档基于品牌分组、基于城市分组,就能得知包含哪些品牌、哪些城市了。
因为是对搜索结果聚合,因此聚合是限定范围的聚合,也就是说聚合的限定条件跟搜索文档的条件一致。
查看浏览器可以发现,前端其实已经发出了这样的一个请求:
请求参数与搜索文档的参数完全一致。
返回值类型就是页面要展示的最终结果:
结果是一个Map结构:
- key是字符串,城市、星级、品牌、价格
- value是集合,例如多个城市的名称
1.3.3.业务实现
在
cn.itcast.hotel.web包的HotelController中添加一个方法,遵循下面的要求:
- 请求方式:
POST- 请求路径:
/hotel/filters- 请求参数:
RequestParams,与搜索文档的参数一致- 返回值类型:
Map<String, List<String>>代码:
@PostMapping("filters")
public Map<String, List<String>> getFilters(@RequestBody RequestParams params){
    return hotelService.getFilters(params);
}
这里调用了IHotelService中的getFilters方法,尚未实现。
在
cn.itcast.hotel.service.IHotelService中定义新方法:Map<String, List<String>> filters(RequestParams params);在
cn.itcast.hotel.service.impl.HotelService中实现该方法:@Override public Map<String, List<String>> filters(RequestParams params) { try { // 1.准备Request SearchRequest request = new SearchRequest("hotel"); // 2.准备DSL // 2.1.query buildBasicQuery(params, request); // 2.2.设置size request.source().size(0); // 2.3.聚合 buildAggregation(request); // 3.发出请求 SearchResponse response = client.search(request, RequestOptions.DEFAULT); // 4.解析结果 Map<String, List<String>> result = new HashMap<>(); Aggregations aggregations = response.getAggregations(); // 4.1.根据品牌名称,获取品牌结果 List<String> brandList = getAggByName(aggregations, "brandAgg"); result.put("品牌", brandList); // 4.2.根据品牌名称,获取品牌结果 List<String> cityList = getAggByName(aggregations, "cityAgg"); result.put("城市", cityList); // 4.3.根据品牌名称,获取品牌结果 List<String> starList = getAggByName(aggregations, "starAgg"); result.put("星级", starList); return result; } catch (IOException e) { throw new RuntimeException(e); } } private void buildAggregation(SearchRequest request) { request.source().aggregation(AggregationBuilders .terms("brandAgg") .field("brand") .size(100) ); request.source().aggregation(AggregationBuilders .terms("cityAgg") .field("city") .size(100) ); request.source().aggregation(AggregationBuilders .terms("starAgg") .field("starName") .size(100) ); } private List<String> getAggByName(Aggregations aggregations, String aggName) { // 4.1.根据聚合名称获取聚合结果 Terms brandTerms = aggregations.get(aggName); // 4.2.获取buckets List<? extends Terms.Bucket> buckets = brandTerms.getBuckets(); // 4.3.遍历 List<String> brandList = new ArrayList<>(); for (Terms.Bucket bucket : buckets) { // 4.4.获取key String key = bucket.getKeyAsString(); brandList.add(key); } return brandList; }2.自动补全
当用户在搜索框输入字符时,我们应该提示出与该字符有关的搜索项,如图:
这种根据用户输入的字母,提示完整词条的功能,就是自动补全了。
因为需要根据拼音字母来推断,因此要用到拼音分词功能。
2.1.拼音分词器
要实现根据字母做补全,就必须对文档按照拼音分词。在GitHub上恰好有elasticsearch的拼音分词插件。地址:https://github.com/medcl/elasticsearch-analysis-pinyin
课前资料中也提供了拼音分词器的安装包:
安装方式与IK分词器一样,分三步:
①解压
②上传到虚拟机中,elasticsearch的plugin目录
③重启elasticsearch
④测试
详细安装步骤可以参考IK分词器的安装过程。
测试用法如下:
POST /_analyze
{
  "text": "如家酒店还不错",
  "analyzer": "pinyin"
}
结果:
2.2.自定义分词器
默认的拼音分词器会将每个汉字单独分为拼音,而我们希望的是每个词条形成一组拼音,需要对拼音分词器做个性化定制,形成自定义分词器。
elasticsearch中分词器(analyzer)的组成包含三部分:
- character filters:在tokenizer之前对文本进行处理。例如删除字符、替换字符
- tokenizer:将文本按照一定的规则切割成词条(term)。例如keyword,就是不分词;还有ik_smart
- tokenizer filter:将tokenizer输出的词条做进一步处理。例如大小写转换、同义词处理、拼音处理等
文档分词时会依次由这三部分来处理文档:
声明自定义分词器的语法如下:
PUT /test
{
  "settings": {
    "analysis": {
      "analyzer": { // 自定义分词器
        "my_analyzer": {  // 分词器名称
          "tokenizer": "ik_max_word",
          "filter": "py"
        }
      },
      "filter": { // 自定义tokenizer filter
        "py": { // 过滤器名称
          "type": "pinyin", // 过滤器类型,这里是pinyin
		  "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "name": {
        "type": "text",
        "analyzer": "my_analyzer",
        "search_analyzer": "ik_smart"
      }
    }
  }
}
测试:
总结:
如何使用拼音分词器?
- ①下载pinyin分词器
- ②解压并放到elasticsearch的plugin目录
- ③重启即可
如何自定义分词器?
- ①创建索引库时,在settings中配置,可以包含三部分
- ②character filter
- ③tokenizer
- ④filter
拼音分词器注意事项?
- 为了避免搜索到同音字,搜索时不要使用拼音分词器
2.3.自动补全查询
elasticsearch提供了Completion Suggester查询来实现自动补全功能。这个查询会匹配以用户输入内容开头的词条并返回。为了提高补全查询的效率,对于文档中字段的类型有一些约束:
- 参与补全查询的字段必须是completion类型。
- 字段的内容一般是用来补全的多个词条形成的数组。
比如,一个这样的索引库:
// 创建索引库
PUT test
{
  "mappings": {
    "properties": {
      "title":{
        "type": "completion"
      }
    }
  }
}
然后插入下面的数据:
// 示例数据
POST test/_doc
{
  "title": ["Sony", "WH-1000XM3"]
}
POST test/_doc
{
  "title": ["SK-II", "PITERA"]
}
POST test/_doc
{
  "title": ["Nintendo", "switch"]
}
查询的DSL语句如下:
// 自动补全查询
GET /test/_search
{
  "suggest": {
    "title_suggest": {
      "text": "s", // 关键字
      "completion": {
        "field": "title", // 补全查询的字段
        "skip_duplicates": true, // 跳过重复的
        "size": 10 // 获取前10条结果
      }
    }
  }
}
2.4.实现酒店搜索框自动补全
现在,我们的hotel索引库还没有设置拼音分词器,需要修改索引库中的配置。但是我们知道索引库是无法修改的,只能删除然后重新创建。
另外,我们需要添加一个字段,用来做自动补全,将brand、suggestion、city等都放进去,作为自动补全的提示。
因此,总结一下,我们需要做的事情包括:
- 修改hotel索引库结构,设置自定义拼音分词器
- 修改索引库的name、all字段,使用自定义分词器
- 索引库添加一个新字段suggestion,类型为completion类型,使用自定义的分词器
- 给HotelDoc类添加suggestion字段,内容包含brand、business
- 重新导入数据到hotel库
2.4.1.修改酒店映射结构
代码如下:
// 酒店数据索引库
PUT /hotel
{
  "settings": {
    "analysis": {
      "analyzer": {
        "text_anlyzer": {
          "tokenizer": "ik_max_word",
          "filter": "py"
        },
        "completion_analyzer": {
          "tokenizer": "keyword",
          "filter": "py"
        }
      },
      "filter": {
        "py": {
          "type": "pinyin",
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "id":{
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_smart",
        "copy_to": "all"
      },
      "address":{
        "type": "keyword",
        "index": false
      },
      "price":{
        "type": "integer"
      },
      "score":{
        "type": "integer"
      },
      "brand":{
        "type": "keyword",
        "copy_to": "all"
      },
      "city":{
        "type": "keyword"
      },
      "starName":{
        "type": "keyword"
      },
      "business":{
        "type": "keyword",
        "copy_to": "all"
      },
      "location":{
        "type": "geo_point"
      },
      "pic":{
        "type": "keyword",
        "index": false
      },
      "all":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_smart"
      },
      "suggestion":{
          "type": "completion",
          "analyzer": "completion_analyzer"
      }
    }
  }
}
2.4.2.修改HotelDoc实体
HotelDoc中要添加一个字段,用来做自动补全,内容可以是酒店品牌、城市、商圈等信息。按照自动补全字段的要求,最好是这些字段的数组。
因此我们在HotelDoc中添加一个suggestion字段,类型为
List<String>,然后将brand、city、business等信息放到里面。代码如下:
package cn.itcast.hotel.pojo;

import lombok.Data;
import lombok.NoArgsConstructor;

import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collections;
import java.util.List;

@Data
@NoArgsConstructor
public class HotelDoc {
    private Long id;
    private String name;
    private String address;
    private Integer price;
    private Integer score;
    private String brand;
    private String city;
    private String starName;
    private String business;
    private String location;
    private String pic;
    private Object distance;
    private Boolean isAD;
    private List<String> suggestion;

    public HotelDoc(Hotel hotel) {
        this.id = hotel.getId();
        this.name = hotel.getName();
        this.address = hotel.getAddress();
        this.price = hotel.getPrice();
        this.score = hotel.getScore();
        this.brand = hotel.getBrand();
        this.city = hotel.getCity();
        this.starName = hotel.getStarName();
        this.business = hotel.getBusiness();
        this.location = hotel.getLatitude() + ", " + hotel.getLongitude();
        this.pic = hotel.getPic();
        // 组装suggestion
        if(this.business.contains("/")){
            // business有多个值,需要切割
            String[] arr = this.business.split("/");
            // 添加元素
            this.suggestion = new ArrayList<>();
            this.suggestion.add(this.brand);
            Collections.addAll(this.suggestion, arr);
        }else {
            this.suggestion = Arrays.asList(this.brand, this.business);
        }
    }
}
2.4.3.重新导入
重新执行之前编写的导入数据功能,可以看到新的酒店数据中包含了suggestion:
2.4.4.自动补全查询的JavaAPI
之前我们学习了自动补全查询的DSL,而没有学习对应的JavaAPI,这里给出一个示例:
而自动补全的结果也比较特殊,解析的代码如下:
2.4.5.实现搜索框自动补全
查看前端页面,可以发现当我们在输入框键入时,前端会发起ajax请求:
返回值是补全词条的集合,类型为
List<String>1)在
cn.itcast.hotel.web包下的HotelController中添加新接口,接收新的请求:@GetMapping("suggestion") public List<String> getSuggestions(@RequestParam("key") String prefix) { return hotelService.getSuggestions(prefix); }2)在
cn.itcast.hotel.service包下的IhotelService中添加方法:List<String> getSuggestions(String prefix);3)在
cn.itcast.hotel.service.impl.HotelService中实现该方法:@Override public List<String> getSuggestions(String prefix) { try { // 1.准备Request SearchRequest request = new SearchRequest("hotel"); // 2.准备DSL request.source().suggest(new SuggestBuilder().addSuggestion( "suggestions", SuggestBuilders.completionSuggestion("suggestion") .prefix(prefix) .skipDuplicates(true) .size(10) )); // 3.发起请求 SearchResponse response = client.search(request, RequestOptions.DEFAULT); // 4.解析结果 Suggest suggest = response.getSuggest(); // 4.1.根据补全查询名称,获取补全结果 CompletionSuggestion suggestions = suggest.getSuggestion("suggestions"); // 4.2.获取options List<CompletionSuggestion.Entry.Option> options = suggestions.getOptions(); // 4.3.遍历 List<String> list = new ArrayList<>(options.size()); for (CompletionSuggestion.Entry.Option option : options) { String text = option.getText().toString(); list.add(text); } return list; } catch (IOException e) { throw new RuntimeException(e); } }3.数据同步
elasticsearch中的酒店数据来自于mysql数据库,因此mysql数据发生改变时,elasticsearch也必须跟着改变,这个就是elasticsearch与mysql之间的数据同步
3.1.思路分析
常见的数据同步方案有三种:
- 同步调用
- 异步通知
- 监听binlog
3.1.1.同步调用
方案一:同步调用
基本步骤如下:
- hotel-demo对外提供接口,用来修改elasticsearch中的数据
- 酒店管理服务在完成数据库操作后,直接调用hotel-demo提供的接口,
3.1.2.异步通知
方案二:异步通知
流程如下:
- hotel-admin对mysql数据库数据完成增、删、改后,发送MQ消息
- hotel-demo监听MQ,接收到消息后完成elasticsearch数据修改
3.1.3.监听binlog
方案三:监听binlog
流程如下:
- 给mysql开启binlog功能
- mysql完成增、删、改操作都会记录在binlog中
- hotel-demo基于canal监听binlog变化,实时更新elasticsearch中的内容
3.1.4.选择
方式一:同步调用
- 优点:实现简单,粗暴
- 缺点:业务耦合度高
方式二:异步通知
- 优点:低耦合,实现难度一般
- 缺点:依赖mq的可靠性
方式三:监听binlog
- 优点:完全解除服务间耦合
- 缺点:开启binlog增加数据库负担、实现复杂度高
3.2.实现数据同步
3.2.1.思路
利用课前资料提供的hotel-admin项目作为酒店管理的微服务。当酒店数据发生增、删、改时,要求对elasticsearch中数据也要完成相同操作。
步骤:
- 导入课前资料提供的hotel-admin项目,启动并测试酒店数据的CRUD
- 声明exchange、queue、RoutingKey
- 在hotel-admin中的增、删、改业务中完成消息发送
- 在hotel-demo中完成消息监听,并更新elasticsearch中数据
- 启动并测试数据同步功能
3.2.2.导入demo
导入课前资料提供的hotel-admin项目:
运行后,访问 http://localhost:8099
其中包含了酒店的CRUD功能:
3.2.3.声明交换机、队列
MQ结构如图:
1)引入依赖
在hotel-admin、hotel-demo中引入rabbitmq的依赖:
<!--amqp-->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>
2)声明队列交换机名称
在hotel-admin和hotel-demo中的
cn.itcast.hotel.constatnts包下新建一个类MqConstants:package cn.itcast.hotel.constatnts; public class MqConstants { /** * 交换机 */ public final static String HOTEL_EXCHANGE = "hotel.topic"; /** * 监听新增和修改的队列 */ public final static String HOTEL_INSERT_QUEUE = "hotel.insert.queue"; /** * 监听删除的队列 */ public final static String HOTEL_DELETE_QUEUE = "hotel.delete.queue"; /** * 新增或修改的RoutingKey */ public final static String HOTEL_INSERT_KEY = "hotel.insert"; /** * 删除的RoutingKey */ public final static String HOTEL_DELETE_KEY = "hotel.delete"; }3)声明队列交换机
在hotel-demo中,定义配置类,声明队列、交换机:
package cn.itcast.hotel.config;

import cn.itcast.hotel.constants.MqConstants;
import org.springframework.amqp.core.Binding;
import org.springframework.amqp.core.BindingBuilder;
import org.springframework.amqp.core.Queue;
import org.springframework.amqp.core.TopicExchange;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class MqConfig {
    @Bean
    public TopicExchange topicExchange(){
        return new TopicExchange(MqConstants.HOTEL_EXCHANGE, true, false);
    }

    @Bean
    public Queue insertQueue(){
        return new Queue(MqConstants.HOTEL_INSERT_QUEUE, true);
    }

    @Bean
    public Queue deleteQueue(){
        return new Queue(MqConstants.HOTEL_DELETE_QUEUE, true);
    }

    @Bean
    public Binding insertQueueBinding(){
        return BindingBuilder.bind(insertQueue()).to(topicExchange()).with(MqConstants.HOTEL_INSERT_KEY);
    }

    @Bean
    public Binding deleteQueueBinding(){
        return BindingBuilder.bind(deleteQueue()).to(topicExchange()).with(MqConstants.HOTEL_DELETE_KEY);
    }
}
3.2.4.发送MQ消息
在hotel-admin中的增、删、改业务中分别发送MQ消息:
3.2.5.接收MQ消息
hotel-demo接收到MQ消息要做的事情包括:
- 新增消息:根据传递的hotel的id查询hotel信息,然后新增一条数据到索引库
- 删除消息:根据传递的hotel的id删除索引库中的一条数据
1)首先在hotel-demo的
cn.itcast.hotel.service包下的IHotelService中新增新增、删除业务void deleteById(Long id); void insertById(Long id);2)给hotel-demo中的
cn.itcast.hotel.service.impl包下的HotelService中实现业务:@Override public void deleteById(Long id) { try { // 1.准备Request DeleteRequest request = new DeleteRequest("hotel", id.toString()); // 2.发送请求 client.delete(request, RequestOptions.DEFAULT); } catch (IOException e) { throw new RuntimeException(e); } } @Override public void insertById(Long id) { try { // 0.根据id查询酒店数据 Hotel hotel = getById(id); // 转换为文档类型 HotelDoc hotelDoc = new HotelDoc(hotel); // 1.准备Request对象 IndexRequest request = new IndexRequest("hotel").id(hotel.getId().toString()); // 2.准备Json文档 request.source(JSON.toJSONString(hotelDoc), XContentType.JSON); // 3.发送请求 client.index(request, RequestOptions.DEFAULT); } catch (IOException e) { throw new RuntimeException(e); } }3)编写监听器
在hotel-demo中的
cn.itcast.hotel.mq包新增一个类:package cn.itcast.hotel.mq; import cn.itcast.hotel.constants.MqConstants; import cn.itcast.hotel.service.IHotelService; import org.springframework.amqp.rabbit.annotation.RabbitListener; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Component; @Component public class HotelListener { @Autowired private IHotelService hotelService; /** * 监听酒店新增或修改的业务 * @param id 酒店id */ @RabbitListener(queues = MqConstants.HOTEL_INSERT_QUEUE) public void listenHotelInsertOrUpdate(Long id){ hotelService.insertById(id); } /** * 监听酒店删除的业务 * @param id 酒店id */ @RabbitListener(queues = MqConstants.HOTEL_DELETE_QUEUE) public void listenHotelDelete(Long id){ hotelService.deleteById(id); } }4.集群
单机的elasticsearch做数据存储,必然面临两个问题:海量数据存储问题、单点故障问题。
- 海量数据存储问题:将索引库从逻辑上拆分为N个分片(shard),存储到多个节点
- 单点故障问题:将分片数据在不同节点备份(replica )
ES集群相关概念:
集群(cluster):一组拥有共同的 cluster name 的 节点。
节点(node) :集群中的一个 Elasticearch 实例
分片(shard):索引可以被拆分为不同的部分进行存储,称为分片。在集群环境下,一个索引的不同分片可以拆分到不同的节点中
解决问题:数据量太大,单点存储量有限的问题。
此处,我们把数据分成3片:shard0、shard1、shard2
主分片(Primary shard):相对于副本分片的定义。
副本分片(Replica shard)每个主分片可以有一个或者多个副本,数据和主分片一样。
数据备份可以保证高可用,但是每个分片备份一份,所需要的节点数量就会翻一倍,成本实在是太高了!
为了在高可用和成本间寻求平衡,我们可以这样做:
- 首先对数据分片,存储到不同节点
- 然后对每个分片进行备份,放到对方节点,完成互相备份
这样可以大大减少所需要的服务节点数量,如图,我们以3分片,每个分片备份一份为例:
现在,每个分片都有1个备份,存储在3个节点:
- node0:保存了分片0和1
- node1:保存了分片0和2
- node2:保存了分片1和2
4.1.搭建ES集群
参考课前资料的文档:
其中的第四章节:
4.2.集群脑裂问题
4.2.1.集群职责划分
elasticsearch中集群节点有不同的职责划分:
默认情况下,集群中的任何一个节点都同时具备上述四种角色。
但是真实的集群一定要将集群职责分离:
- master节点:对CPU要求高,但是内存要求第
- data节点:对CPU和内存要求都高
- coordinating节点:对网络带宽、CPU要求高
职责分离可以让我们根据不同节点的需求分配不同的硬件去部署。而且避免业务之间的互相干扰。
一个典型的es集群职责划分如图:
4.2.2.脑裂问题
脑裂是因为集群中的节点失联导致的。
例如一个集群中,主节点与其它节点失联:
此时,node2和node3认为node1宕机,就会重新选主:
当node3当选后,集群继续对外提供服务,node2和node3自成集群,node1自成集群,两个集群数据不同步,出现数据差异。
当网络恢复后,因为集群中有两个master节点,集群状态的不一致,出现脑裂的情况:
解决脑裂的方案是,要求选票超过 ( eligible节点数量 + 1 )/ 2 才能当选为主,因此eligible节点数量最好是奇数。对应配置项是discovery.zen.minimum_master_nodes,在es7.0以后,已经成为默认配置,因此一般不会发生脑裂问题
例如:3个节点形成的集群,选票必须超过 (3 + 1) / 2 ,也就是2票。node3得到node2和node3的选票,当选为主。node1只有自己1票,没有当选。集群中依然只有1个主节点,没有出现脑裂。
4.2.3.小结
master eligible节点的作用是什么?
- 参与集群选主
- 主节点可以管理集群状态、管理分片信息、处理创建和删除索引库的请求
data节点的作用是什么?
- 数据的CRUD
coordinator节点的作用是什么?
- 路由请求到其它节点
- 合并查询到的结果,返回给用户
4.3.集群分布式存储
当新增文档时,应该保存到不同分片,保证数据均衡,那么coordinating node如何确定数据该存储到哪个分片呢?
4.3.1.分片存储测试
插入三条数据:
测试可以看到,三条数据分别在不同分片:
结果:
4.3.2.分片存储原理
elasticsearch会通过hash算法来计算文档应该存储到哪个分片:
说明:
- _routing默认是文档的id
- 算法与分片数量有关,因此索引库一旦创建,分片数量不能修改!
新增文档的流程如下:
解读:
- 1)新增一个id=1的文档
- 2)对id做hash运算,假如得到的是2,则应该存储到shard-2
- 3)shard-2的主分片在node3节点,将数据路由到node3
- 4)保存文档
- 5)同步给shard-2的副本replica-2,在node2节点
- 6)返回结果给coordinating-node节点
4.4.集群分布式查询
elasticsearch的查询分成两个阶段:
scatter phase:分散阶段,coordinating node会把请求分发到每一个分片
gather phase:聚集阶段,coordinating node汇总data node的搜索结果,并处理为最终结果集返回给用户
4.5.集群故障转移
集群的master节点会监控集群中的节点状态,如果发现有节点宕机,会立即将宕机节点的分片数据迁移到其它节点,确保数据安全,这个叫做故障转移。
1)例如一个集群结构如图:
现在,node1是主节点,其它两个节点是从节点。
2)突然,node1发生了故障:
宕机后的第一件事,需要重新选主,例如选中了node2:
node2成为主节点后,会检测集群监控状态,发现:shard-1、shard-0没有副本节点。因此需要将node1上的数据迁移到node2、node3:


1、部署单点es
1.1、创建网络
因为我们还需要部署kibana容器,因此需要让es和kibana容器互联。这里先创建一个网络:
docker network create es-net1.2、加载镜像
镜像tar包的下载链接:
**链接:**https://pan.baidu.com/s/10-sd8acWQ-LXqMsqqoBCwA?pwd=t9dr
提取码:t9dr
–来自百度网盘超级会员V5的分享
将其上传到虚拟机中,然后运行命令加载即可:# 导入docker镜像 docker load -i es.tar同理还有kibana的tar包也需要这样做。
1.3、运行
运行docker命令,部署单点es:
docker run -d \ --name es \ -e "ES_JAVA_OPTS=-Xms512m -Xmx512m" \ -e "discovery.type=single-node" \ -v es-data:/usr/share/elasticsearch/data \ -v es-plugins:/usr/share/elasticsearch/plugins \ --privileged \ --network es-net \ -p 9200:9200 \ -p 9300:9300 \ elasticsearch:7.12.1 # 命令解释: -e "cluster.name=es-docker-cluster":设置集群名称 -e "http.host=0.0.0.0":监听的地址,可以外网访问 -e "ES_JAVA_OPTS=-Xms512m -Xmx512m":内存大小 -e "discovery.type=single-node":非集群模式 -v es-data:/usr/share/elasticsearch/data:挂载逻辑卷,绑定es的数据目录 -v es-logs:/usr/share/elasticsearch/logs:挂载逻辑卷,绑定es的日志目录 -v es-plugins:/usr/share/elasticsearch/plugins:挂载逻辑卷,绑定es的插件目录 --privileged:授予逻辑卷访问权 --network es-net:加入一个名为es-net的网络中 -p 9200:9200:端口映射配置在浏览器中输入:http://localhost:9200 即可看到elasticsearch的响应结果:
2、部署kibana
kibana可以给我们提供一个elasticsearch的可视化界面,便于我们学习。
镜像tar包的下载链接:
**链接:**https://pan.baidu.com/s/1cSvro3EDExjN5R9yfZiBKA?pwd=hm9a
提取码:hm9a
–来自百度网盘超级会员V5的分享2.1、部署
运行docker命令,部署kibana
# 导入kibana镜像
docker load -i kibana.tar
# 启动kibana
docker run -d \
--name kibana \
-e ELASTICSEARCH_HOSTS=[http://es:9200](http://es:9200) \
--network=es-net \
-p 5601:5601  \
kibana:7.12.1
# 命令解释:
--network es-net:加入一个名为es-net的网络中,与elasticsearch在同一个网络中
-e ELASTICSEARCH_HOSTS=http://es:9200":设置elasticsearch的地址,因为kibana已经与elasticsearch在一个网络,因此可以用容器名直接访问elasticsearch
-p 5601:5601:端口映射配置
kibana启动一般比较慢,需要多等待一会,可以通过命令:
docker logs -f kibana查看运行日志,当查看到下面的日志,说明成功:
**此时,在浏览器输入地址访问:**http://localhost:5601 ,即可看到结果2.2、DevTools
kibana中提供了一个DevTools界面:
这个界面中可以编写DSL来操作elasticsearch。并且对DSL语句有自动补全功能。3、安装IK分词器
3.1、在线安装ik插件(较慢)
# 进入容器内部 docker exec -it elasticsearch /bin/bash # 在线下载并安装 ./bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v7.12.1/elasticsearch-analysis-ik-7.12.1.zip #退出 exit #重启容器 docker restart elasticsearch3.2、离线安装ik插件(推荐)
1)查看数据卷目录
安装插件需要知道elasticsearch的plugins目录位置,而我们用了数据卷挂载,因此需要查看elasticsearch的数据卷目录,通过下面命令查看:
docker volume inspect es-plugins显示结果:
[
    {
        "CreatedAt": "2022-05-06T10:06:34+08:00",
        "Driver": "local",
        "Labels": null,
        "Mountpoint": "/var/lib/docker/volumes/es-plugins/_data",
        "Name": "es-plugins",
        "Options": null,
        "Scope": "local"
    }
]
**说明plugins目录被挂载到了:****/var/lib/docker/volumes/es-plugins/_data **这个目录中。
2)分词安装包
下载链接如下:
**链接:**https://pan.baidu.com/s/1D5Qsgq7rnq1ZL5y74LmIMw?pwd=d373
提取码:d373
–来自百度网盘超级会员V5的分享3)上传到es容器的插件数据卷中
也就是 /var/lib/docker/volumes/es-plugins/_data**:**
4)重启容器
# 4、重启容器
docker restart es
# 查看es日志 docker logs -f es5)测试:
IK分词器包含两种模式:
- ik_smart :最少切分
- ik_max_word :最细切分
GET /_analyze
{
  "analyzer": "ik_max_word",
  "text": "黑马程序员学习java太棒了"
}
结果:
{
  "tokens" : [
    {
      "token" : "黑马",
      "start_offset" : 0,
      "end_offset" : 2,
      "type" : "CN_WORD",
      "position" : 0
    },
    {
      "token" : "程序员",
      "start_offset" : 2,
      "end_offset" : 5,
      "type" : "CN_WORD",
      "position" : 1
    },
    {
      "token" : "程序",
      "start_offset" : 2,
      "end_offset" : 4,
      "type" : "CN_WORD",
      "position" : 2
    },
    {
      "token" : "员",
      "start_offset" : 4,
      "end_offset" : 5,
      "type" : "CN_CHAR",
      "position" : 3
    },
    {
      "token" : "学习",
      "start_offset" : 5,
      "end_offset" : 7,
      "type" : "CN_WORD",
      "position" : 4
    },
    {
      "token" : "java",
      "start_offset" : 7,
      "end_offset" : 11,
      "type" : "ENGLISH",
      "position" : 5
    },
    {
      "token" : "太棒了",
      "start_offset" : 11,
      "end_offset" : 14,
      "type" : "CN_WORD",
      "position" : 6
    },
    {
      "token" : "太棒",
      "start_offset" : 11,
      "end_offset" : 13,
      "type" : "CN_WORD",
      "position" : 7
    },
    {
      "token" : "了",
      "start_offset" : 13,
      "end_offset" : 14,
      "type" : "CN_CHAR",
      "position" : 8
    }
  ]
}
3.3、扩展词词典
随着互联网的发展,“造词运动”也越发的频繁。出现了很多新的词语,在原有的词汇列表中并不存在。比如:“奥力给”,“啊米诺斯” 等。
所以我们的词汇也需要不断的更新,IK分词器提供了扩展词汇的功能。1)打开IK分词器config目录:
2)在IKAnalyzer.cfg.xml配置文件内容添加:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "[http://java.sun.com/dtd/properties.dtd](http://java.sun.com/dtd/properties.dtd)">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典 *** 添加扩展词典-->
        <entry key="ext_dict">ext.dic</entry>
</properties>
3)新建一个 ext.dic,可以参考config目录下复制一个配置文件(随便哪个都行)进行修改
啊米诺斯
奥力给
4)重启elasticsearch
docker restart es # 查看 日志 docker logs -f es
日志中已经成功加载ext.dic配置文件5)测试效果:
GET /_analyze
{
  "analyzer": "ik_max_word",
  "text": "传智播客Java就业超过90%,奥力给!"
}
注意当前文件的编码必须是 UTF-8 格式,严禁使用Windows记事本编辑
3.4、停用词词典
在互联网项目中,在网络间传输的速度很快,所以很多语言是不允许在网络上传递的,如:关于宗教、政治等敏感词语**** ,那么我们在搜索时也应该忽略当前词汇。
IK分词器也提供了强大的停用词功能,让我们在索引时就直接忽略当前的停用词汇表中的内容。1)IKAnalyzer.cfg.xml配置文件内容添加:
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "[http://java.sun.com/dtd/properties.dtd](http://java.sun.com/dtd/properties.dtd)">
<properties>
        <comment>IK Analyzer 扩展配置</comment>
        <!--用户可以在这里配置自己的扩展字典-->
        <entry key="ext_dict">ext.dic</entry>
         <!--用户可以在这里配置自己的扩展停止词字典  *** 添加停用词词典-->
        <entry key="ext_stopwords">stopword.dic</entry>
</properties>
2)在 stopword.dic 添加停用词
习大大3)重启elasticsearch
# 重启服务
docker restart es
# 查看 日志
docker logs -f es
4)测试效果:
GET /_analyze
{
  "analyzer": "ik_max_word",
  "text": "传智播客Java就业率超过95%,习大大都点赞,奥力给!"
}
注意当前文件的编码必须是 UTF-8 格式,严禁使用Windows记事本编辑
4、安装拼音分词器
下载链接如下:
**链接:**https://pan.baidu.com/s/1cvoABBQpnswUd76fX9o5tQ?pwd=9uyi
提取码:9uyi
–来自百度网盘超级会员V5的分享具体安装过程同IK一样
** ① 上传到虚拟机中,elasticsearch的****plugin目录**
② 重启elasticsearch
③ 测试
测试用法如下:POST /_analyze { "text": "如家酒店还不错", "analyzer": "pinyin" }结果:
5、部署es集群
部署es集群可以直接使用docker-compose来完成,不过要求你的Linux虚拟机至少有4G的内存空间
首先编写一个docker-compose文件,内容如下:version: '2.2' services: es01: image: docker.elastic.co/elasticsearch/elasticsearch:7.12.1 container_name: es01 environment: - node.name=es01 - cluster.name=es-docker-cluster - discovery.seed_hosts=es02,es03 - cluster.initial_master_nodes=es01,es02,es03 - bootstrap.memory_lock=true - "ES_JAVA_OPTS=-Xms512m -Xmx512m" ulimits: memlock: soft: -1 hard: -1 volumes: - data01:/usr/share/elasticsearch/data ports: - 9200:9200 networks: - elastic es02: image: docker.elastic.co/elasticsearch/elasticsearch:7.12.1 container_name: es02 environment: - node.name=es02 - cluster.name=es-docker-cluster - discovery.seed_hosts=es01,es03 - cluster.initial_master_nodes=es01,es02,es03 - bootstrap.memory_lock=true - "ES_JAVA_OPTS=-Xms512m -Xmx512m" ulimits: memlock: soft: -1 hard: -1 volumes: - data02:/usr/share/elasticsearch/data networks: - elastic es03: image: docker.elastic.co/elasticsearch/elasticsearch:7.12.1 container_name: es03 environment: - node.name=es03 - cluster.name=es-docker-cluster - discovery.seed_hosts=es01,es02 - cluster.initial_master_nodes=es01,es02,es03 - bootstrap.memory_lock=true - "ES_JAVA_OPTS=-Xms512m -Xmx512m" ulimits: memlock: soft: -1 hard: -1 volumes: - data03:/usr/share/elasticsearch/data networks: - elastic volumes: data01: driver: local data02: driver: local data03: driver: local networks: elastic: driver: bridgeRun docker-compose to bring up the cluster:
docker-compose up
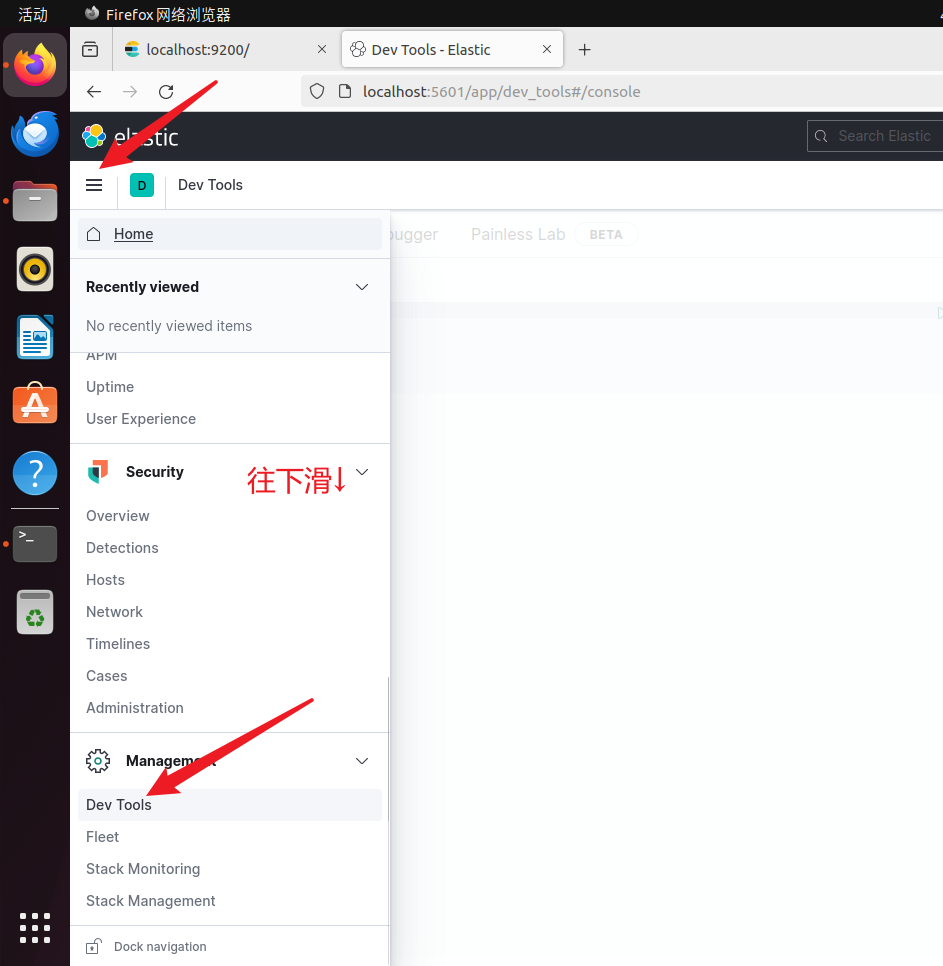
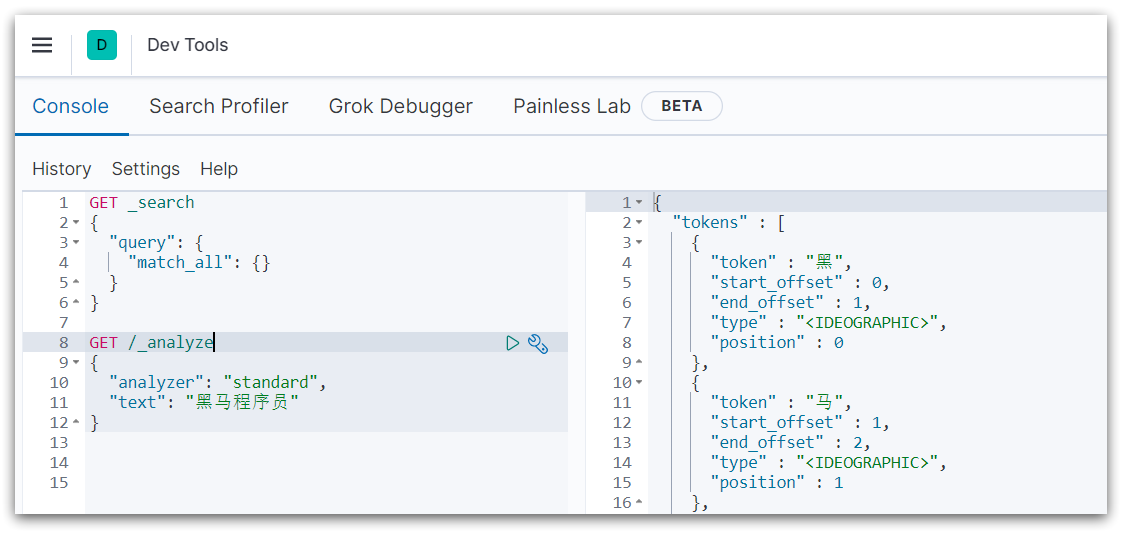
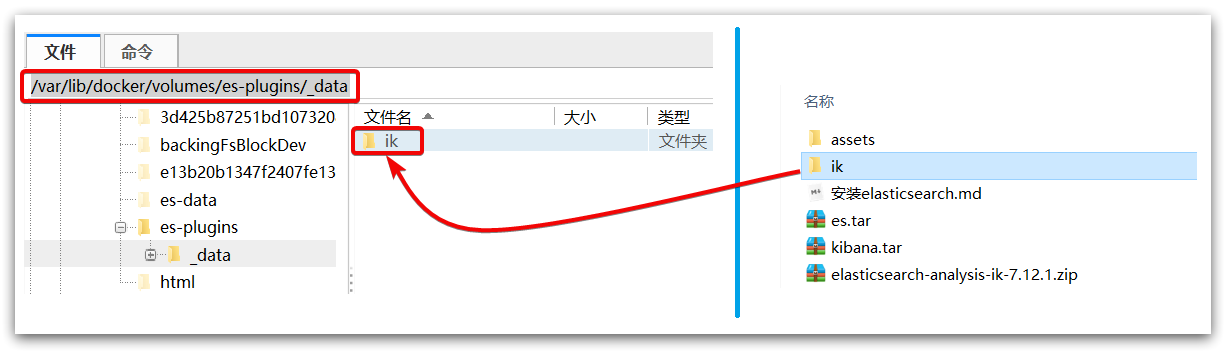
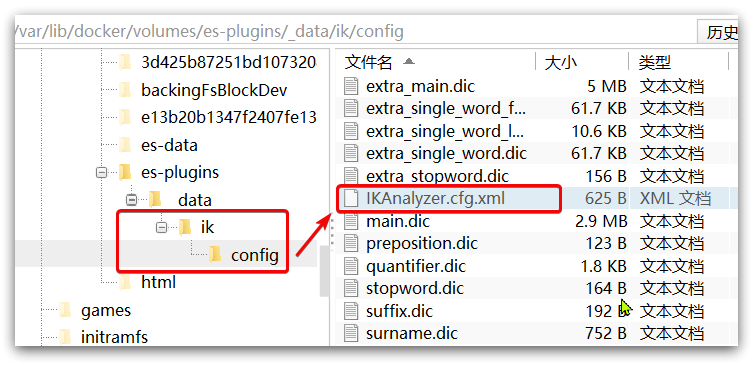
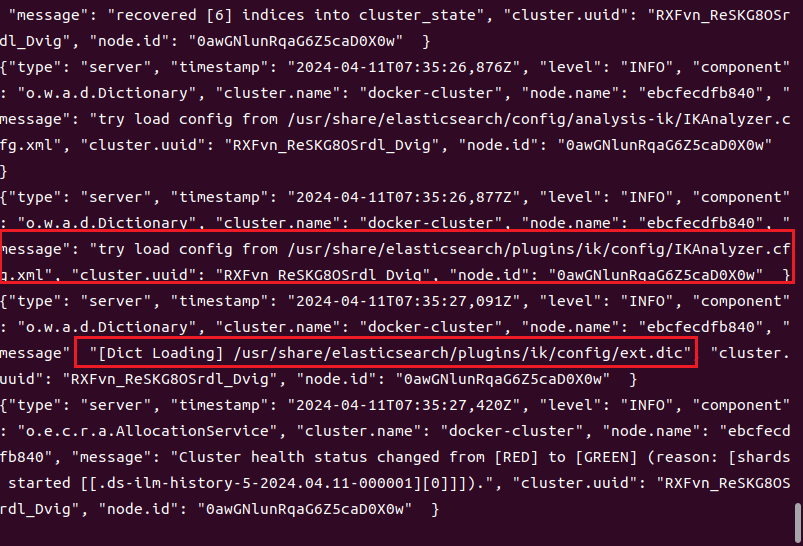
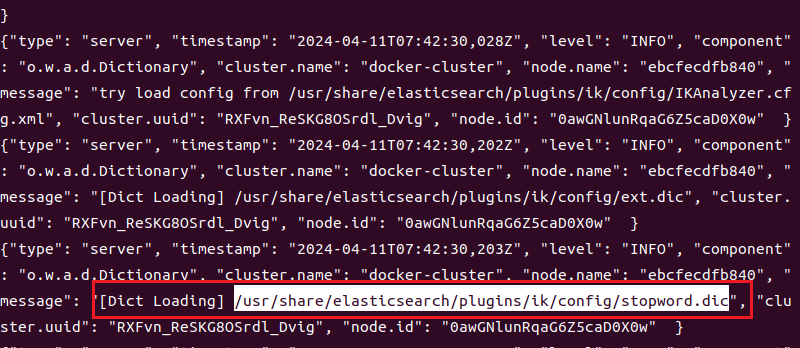
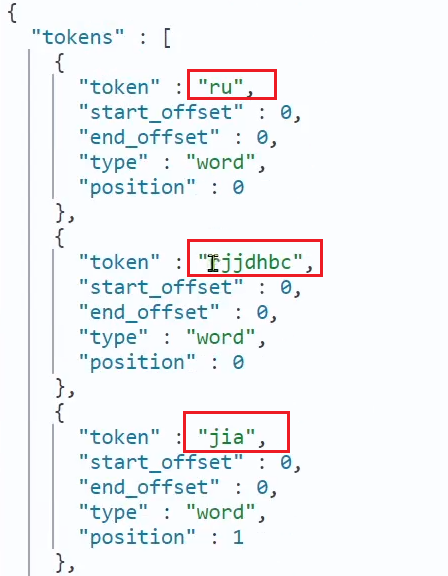
1、Nacos
((20251130181901-46n42tm ‘Nacos安装指南’))
2、RabbitMQ
((20251130181901-pccg7pz ‘RabbitMQ部署指南’))
3、Elasticsearch
((20251130181902-im7bwbs ‘elasticsearch安装指南’))
酒店索引库与数据库
// 酒店数据索引库
PUT /hotel
{
  "settings": {
    "analysis": {
      "analyzer": {
        "text_anlyzer": {
          "tokenizer": "ik_max_word",
          "filter": "py"
        },
        "completion_analyzer": {
          "tokenizer": "keyword",
          "filter": "py"
        }
      },
      "filter": {
        "py": {
          "type": "pinyin",
          "keep_full_pinyin": false,
          "keep_joined_full_pinyin": true,
          "keep_original": true,
          "limit_first_letter_length": 16,
          "remove_duplicated_term": true,
          "none_chinese_pinyin_tokenize": false
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "id":{
        "type": "keyword"
      },
      "name":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_smart",
        "copy_to": "all"
      },
      "address":{
        "type": "keyword",
        "index": false
      },
      "price":{
        "type": "integer"
      },
      "score":{
        "type": "integer"
      },
      "brand":{
        "type": "keyword",
        "copy_to": "all"
      },
      "city":{
        "type": "keyword"
      },
      "starName":{
        "type": "keyword"
      },
      "business":{
        "type": "keyword",
        "copy_to": "all"
      },
      "location":{
        "type": "geo_point"
      },
      "pic":{
        "type": "keyword",
        "index": false
      },
      "all":{
        "type": "text",
        "analyzer": "text_anlyzer",
        "search_analyzer": "ik_smart"
      },
      "suggestion":{
          "type": "completion",
          "analyzer": "completion_analyzer"
      }
    }
  }
}